Error mitigation
Nagbibigay ang araling ito ng background sa iba't ibang teknik ng error mitigation para matulungan ang mga user na magkaroon ng intuwisyon kung paano at kailan pinakamainam gamitin ang mga ito. Mahalaga, ang mga makabagong aplikasyon ng mga teknik na ito ay gagamit ng mas sopistikadong mga tool, tulad ng Samplomatic, Shaded Lightcones, at Executor. Tatalakayin ang mga workflow na iyon sa mga susunod na aralin.
Nagbibigay ang video na ito ng pangkalahatang-ideya ng mga teknik ng error mitigation. Dinadagdagan ng teksto sa ibaba ang detalye at ine-explore ang mga pamamaraang ito gamit ang Qiskit.
Pangkalahatang-ideya ng mga teknik ng error mitigation
Ang error mitigation ay tumutukoy sa anumang proseso na sumusubok na bawasan ang epekto ng mga error sa mga quantum computation matapos ang mga ito mangyari. Iba ito sa suppression, na sumusubok pigilan ang mga error, at sa error correction, na nag-eencode ng impormasyon sa maraming pisikal na qubit at sinusuri ang consistency ng impormasyong iyon para mapanatili ang impormasyon sa iisang logical qubit. Sa buong araling ito, pinakamainam na maunawaan ang mga teknik ng error mitigation bilang mga pamamaraan para bumuo ng mas mahusay na estimator ng mga ideal na expectation value o mas mahusay na sampler ng mga probability distribution, hindi bilang mga pamamaraan para itama ang mga quantum state habang tumatakbo. Susuriin natin sa ibaba ang mga pamamaraan ng error mitigation, na lahat ay available sa Qiskit at sa mga addon nito, at mga promising na tool sa paghahangad ng quantum advantage.
Ang Twirled readout error extinction (TREX) ay nagra-randomize ng proseso ng pagsukat sa pamamagitan ng paglalapat ng mga random na napiling Pauli operation bago ang pagsukat at pagkatapos ay klasikal na pag-undo sa mga kilalang epekto nito sa mga naobserbahang bitstring. Sa ilalim ng angkop na mga pagpapalagay sa measurement-noise, ginagawa nitong mas simple at mas simetrikong anyo ang readout error channel na mas madaling i-calibrate at i-mitigate.
Ang Matrix-free measurement mitigation (M3) ay isang scalable na teknik ng measurement-error mitigation na iniiwasang tahasang buuin ang assignment matrix o ang inverse nito.
Ang Zero noise extrapolation (ZNE) ay tinatantya ang halaga na magkakaroon ng isang observable kung walang noise sa pamamagitan ng artipisyal na pag-scale ng noise sa isang kilalang salik at pag-extrapolate pabalik sa zero-noise na kaso. Nangangailangan ito na ang noise ay mag-scale sa predictable na paraan. Maaaring mangailangan ang predictability na iyon ng iba pang pamamaraang tinalakay sa araling ito (pulse stretching, gate folding, at probabilistic error amplification (PEA)).
Ang Probabilistic error cancellation (PEC) ay isa sa pinakamakapangyarihan, ngunit pinakamahal din sa computation, na teknik ng error mitigation. Gumagana ito sa pamamagitan ng pag-aaral sa noise behavior ng sistema at pagtatangkang i-undo ang noise sa pamamagitan ng istatistikal na pagbuo ng unbiased na tantiya ng ideal na computation. Ang output ng PEC ay mga observable na istatistikal na naitama, hindi mga resultang error-corrected.
Susuriin na natin ngayon nang malalim ang bawat isa sa mga pamamaraang ito.
M3
Ang mga measurement error ay isa sa pinaka-persistent at pinaka-hardware-specific na pinagmumulan ng noise sa mga near-term na quantum device. Kahit tama ang pagkakahanda at pag-evolve ng isang quantum state, maaaring mag-ulat ng maling computational basis outcome ang huling hakbang ng readout. Nagmumula ang mga error na ito sa hindi perpektong pagkilala sa pagitan ng mga pisikal na estadong tumutugma sa at , relaxation habang sinusukat, at mga imperpeksyon sa measurement electronics. Bilang resulta, ang naobserbahang distribution ng mga bitstring ay madalas na isang baluktot na bersyon ng totoong (ideal) distribution, na may probabilidad na maling nai-reassign sa pagitan ng mga outcome.
Tinutugunan ng measurement mitigation ang problemang ito sa pamamagitan ng tahasang pagmomodelo kung paano nama-misassign ang mga measurement outcome. Sa karaniwang pormulasyon, ang behavior na ito ay kinakatawan ng isang assignment matrix , na ang mga elementong ay kumakatawan sa probabilidad ng pagtatala ng outcome kapag ang totoong basis state ay . Kung ang measurement noise ay klasikal at stationary, ang naobserbahang probability vector na ay may kaugnayan sa ideal na distribution na sa pamamagitan ng simpleng linear na relasyon,
Tandaan na ang assignment matrix na ay isang klasikal na stochastic map, hindi isang quantum channel. Kumikilos ito sa mga klasikal na readout, hindi sa mga pinagbabatayang quantum state na na-sample para makuha ang mga readout.
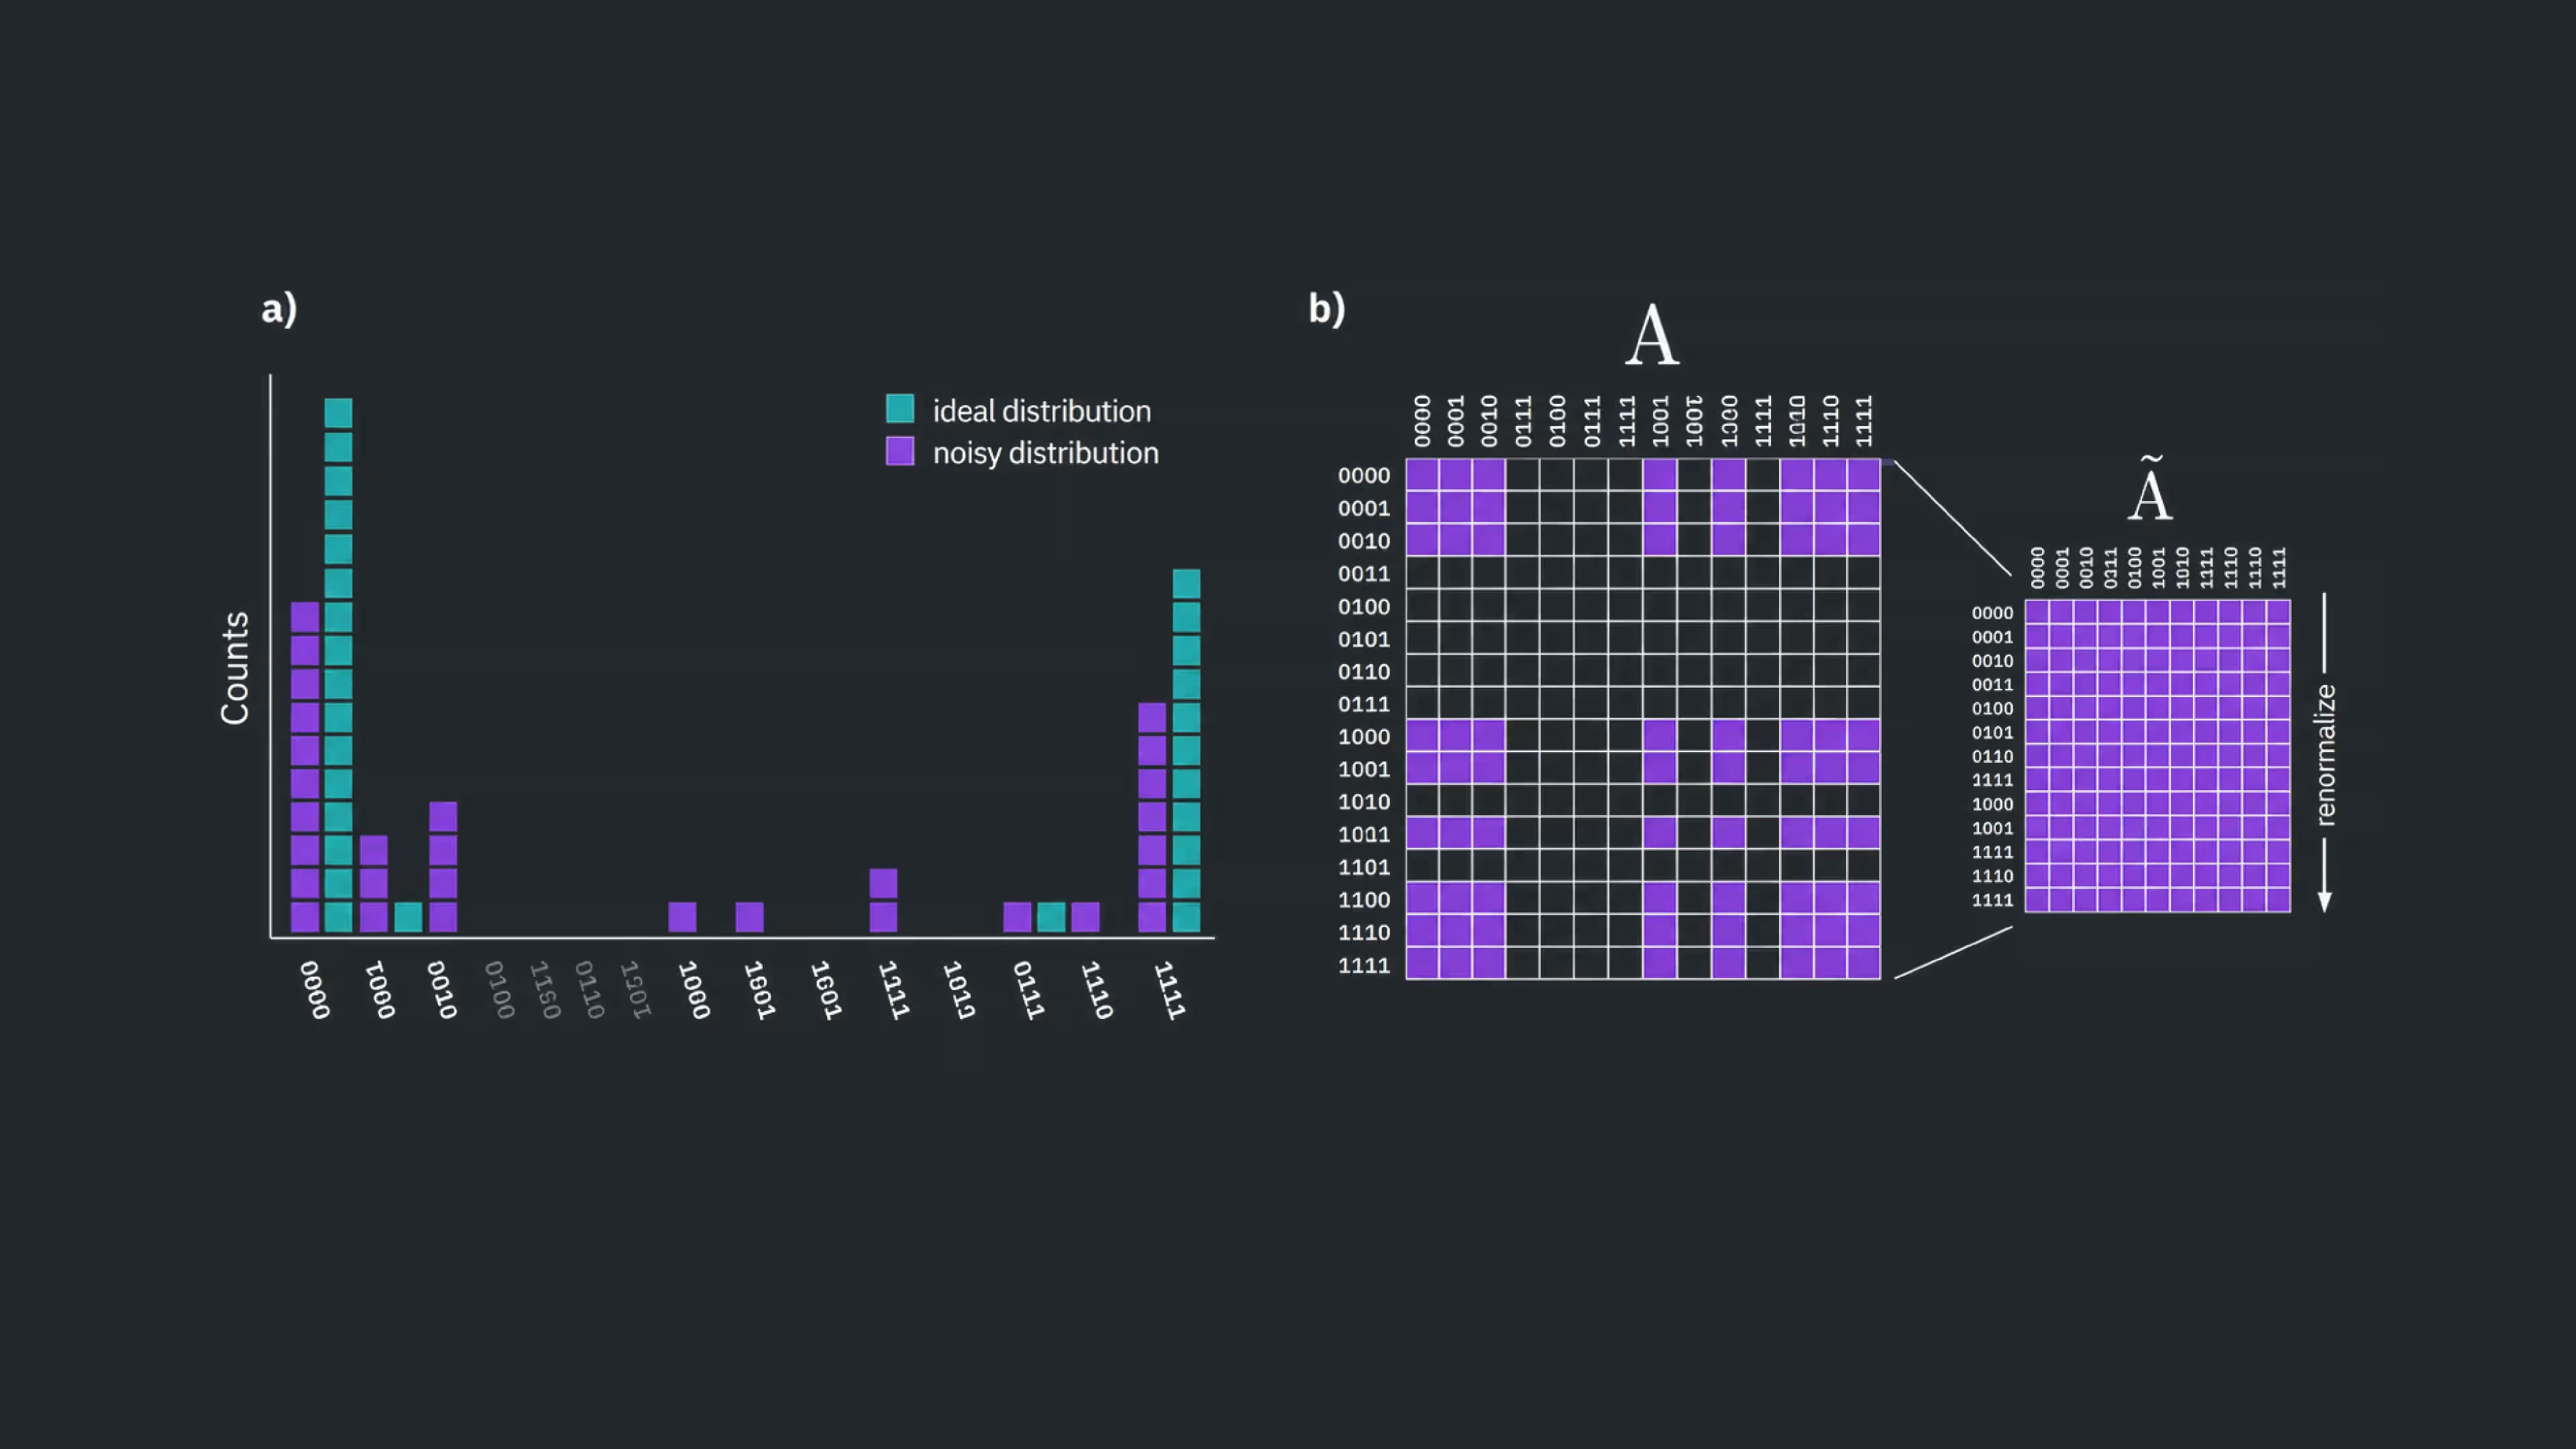
Ginagamit ng Matrix-free measurement mitigation (M3) ang istrukturang ito para bumuo ng mitigated na tantiya ng nang hindi kailanman binubuo o ini-invert ang buong matrix na , na hindi magagawa para sa malaking bilang ng qubit. Sa halip, sinasamantala ng M3 ang katotohanang maraming near-term na quantum workload ay gumagawa ng mga distribution na mataas ang peak o mababa ang entropy, kaya ang mitigation ay nakatuon lamang sa subset ng mga outcome na malaki ang ambag sa naobserbahang distribution.
Para buuin ang assignment model, kailangang magpatakbo ng mga karagdagang calibration experiment sa quantum hardware. Karaniwang kasama rito ang paghahanda ng mga kilalang computational basis state at pagtatala kung paano ito iniuulat ng measurement system. Ang calibration overhead ay lumalaki ayon sa bilang ng mga sinukat na qubit, habang ang computational cost ng mitigation ay nakadepende sa istruktura ng naobserbahang distribution. Mas maliit nang malaki ang cost na ito kaysa sa kakailanganin para tahasang i-characterize ang buong na assignment matrix. Bagama't totoo ang calibration overhead na ito, magaan ito kumpara sa mga circuit-level na teknik tulad ng zero-noise extrapolation o probabilistic error cancellation, kaya ang M3 ay isang praktikal at malawakang ginagamit na tool para sa pag-mitigate ng mga readout error sa mga near-term na quantum experiment.
Tandaan na kapaki-pakinabang lamang ang calibration hangga't nananatiling sapat na stable ang proseso ng pagsukat sa pagitan ng mga calibration run at ng target na experiment.
Magsasagawa muna tayo ng simpleng kaso nang mano-mano para ilarawan kung paano ito gumagana, at pagkatapos ay gagamit ng mga tool na built-in sa Qiskit para ipakita ang paggamit ng M3 sa mas makatotohanang sukat.
Maliit na halimbawa ng M3
Magsisimula tayo sa pagbuo ng simpleng Bell state.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Maaari tayong gumamit ng simulator na may noise model dahil nililimitahan natin ang halimbawang ito sa napakaliit na circuit. Tahasan nating kino-configure ang noise model natin para magkaroon ng readout error sa anyong:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Mas mataas nang malaki ang mga readout error rate na ito kaysa sa nakikita sa mga totoong IBM® quantum computer. Pinili ang mataas na mga halaga para sa layuning pang-edukasyon, para malinaw nating makita ang epekto ng M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Maaari nating patakbuhin ang circuit sa noisy simulator para obserbahan ang mga epekto ng readout error.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Sa toy example natin, tayo ang nagtakda ng readout error para sa noise model natin. Ngunit kapag gumagamit ng totoong quantum computer, hindi alam nang maaga ang readout error. Sa halip, kailangan itong tantiyahin sa pamamagitan ng eksperimento. Para dito, gumagawa tayo ng mga circuit para ihanda ang isang qubit sa kilalang computational basis state na o at sukatin ito. Kung walang readout error, eksaktong ang inihandang estado ang masusukat natin. Sa pagkolekta ng estadistika mula sa mga pagsukat na ito, makakabuo tayo ng assignment matrix na naglalarawan sa readout error. Sa toy example na ito, dapat itong magmukhang katulad ng ating itinakda.
Para sa mas makatotohanang sistema, kailangang tipunin ang estadistika para sa bawat pisikal na qubit. Minsan hindi ito madali, dahil minamapa ng transpilation ang isang abstract na circuit sa hardware at nagbabago ang numero ng qubit. Babalikan natin iyon sa susunod na halimbawa. Sa simulator example na ito, itinalaga natin ang parehong readout-error model sa bawat qubit, kaya sapat na ang isang characterization.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Tandaan na napakalapit nito sa readout error matrix na ginamit sa pagbuo ng simulator.
Muli, sa totoong quantum computer ay magkakaroon tayo ng ganitong estadistika para sa maraming pisikal na qubit. Para sa simulator na ito, ipinapalagay nating magkapareho at independent ang readout error ng dalawang qubit, na nagpapahintulot sa atin na buuin ang two-qubit assignment matrix na A_2q bilang tensor product ng mga katumbas na one-qubit matrix. Tandaan din na ang punto ng M3 ay hindi ang buuin ang buong assignment matrix. Sa halip, nakatuon ang M3 sa subset ng mga outcome na malaki ang ambag sa naobserbahang distribution. Bubuuin natin ang buong matrix para sa napakaliit nating halimbawa para makita kung paano ito gumagana. Mas sopistikado ang implementasyon ng M3 sa qiskit-ibm-runtime kaysa sa toy example na ito dahil kailangan nitong humawak ng maraming qubit na may magkakaibang readout characteristic habang iniiwasan pa ring buuin ang buong assignment matrix.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Para sa halimbawang ito, ipinapalagay nating independent ang mga readout error sa magkakaibang qubit, na nagpapahintulot na buuin ang two-qubit assignment matrix bilang tensor product ng mga katumbas na one-qubit matrix.
Kukunin natin ang raw at mitigated na mga resulta para sa paghahambing.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
Sa puntong ito, na-characterize na natin sa pamamagitan ng eksperimento kung paano binabaluktot ng proseso ng pagsukat ang mga ideal na probabilidad ng outcome. Layunin natin ngayong i-undo ang pagbaluktot na ito at ilapat ang nagresultang correction sa mga raw na probabilidad.
Dahil nagsasagawa tayo ng linear inversion sa halip na pisikal na correction, hindi laging positibo ang mga nagreresultang "probabilidad". Inaasahan ang napakaliliit na negatibong quasi-probability at sinasalamin nito ang katotohanang ang measurement mitigation ay gumagawa ng estimator sa halip na pisikal na probability distribution.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Kino-convert natin ang mga ito sa counts para sa pag-plot.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Sa wakas, tinitingnan natin ang raw, mitigated, at ideal na mga distribution. Ang mga mitigated na "counts" sa ibaba ay pantulong lamang sa visualization na nakuha sa pamamagitan ng pag-rescale ng mga mitigated na quasi-probability.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
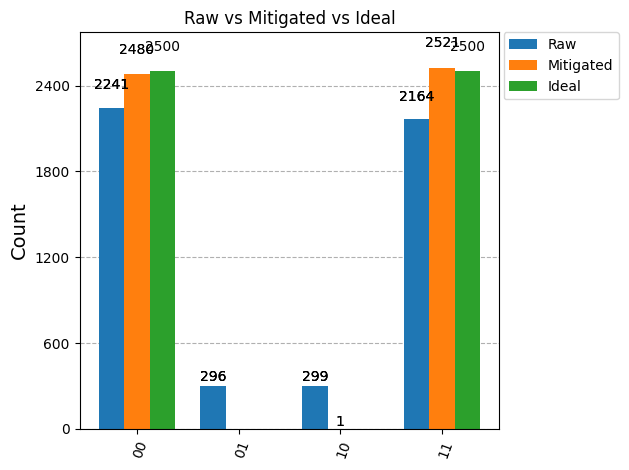
Malinaw na mas malapit sa ideal na mga distribution ang mga resultang M3-mitigated, at makikita natin kung bakit.
Mas komplikado nang malaki ang paglalapat ng M3 sa mas makatotohanang mga workflow. Isaalang-alang:
- Ang mga totoong quantum computer ay may maraming pisikal na qubit, bawat isa ay may sariling readout-error characteristic. Kailangang imodelo at pagsamahin nang naaangkop ang mga error na ito.
- Ang buong assignment matrix na ay lumalaki nang exponential ayon sa bilang ng qubit at mabilis na nagiging imposibleng buuin nang tahasan. Kaya nakatuon ang M3 sa subset ng mga outcome na malaki ang ambag sa naobserbahang distribution sa halip na buuin ang buong assignment matrix.
- Para sa mga totoong problemang interesado tayo, maaaring hindi alam ang ideal na distribution.
Dahil sa lahat ng mga dahilang ito, nakapaloob ang buong mitigation workflow sa mthree Qiskit addon.
Mas malaking halimbawa ng M3
Ngayon ay ilalapat natin ang M3 sa mas malaking circuit, isa kung saan magiging nakakapagod ang mano-manong pagtukoy sa kaugnay na subspace ng , ngunit sapat pa ring simple para malaman natin ang ideal na distribution: isang GHZ state. Magsisimula tayo sa pag-import ng package na mthree at pagdedefine ng isang GHZ quantum circuit.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
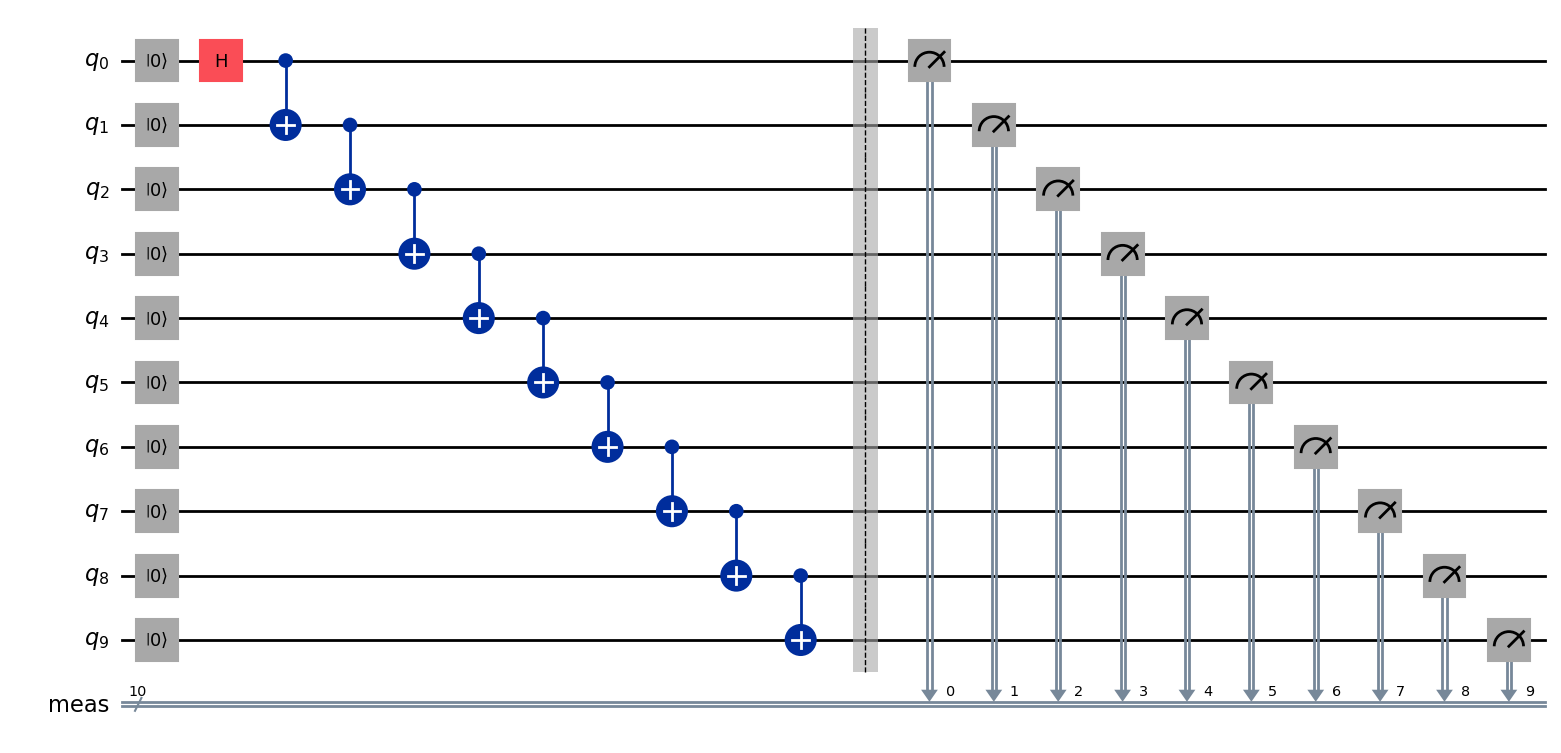
Para patakbuhin ito sa totoong quantum computer, ini-import natin ang qiskit_ibm_runtime at iba pang kinakailangang package. Ginagamit natin ang SamplerV2 para makakuha ng distribution ng mga output.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Ngayon ay tina-transpile natin ang circuit sa ating backend. Itinatakda natin dito ang optimization level sa 0 para tumuon sa mga epekto ng M3, nang walang dagdag na mga tool. Nangangahulugan ito na hindi kakatawan ang huling fidelity sa kayang makamit sa IBM Quantum® hardware gamit ang buong suite ng mga available na tool, ngunit pinapayagan tayo nitong tumuon partikular sa pagiging kapaki-pakinabang ng M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Ngayon ay kino-configure natin ang Sampler, muling dini-disable ang mga karagdagang teknik ng error suppression tulad ng dynamical decoupling at twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Sa wakas, isasagawa natin ang ating job.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Maaari nating kunin ang mga raw count mula sa circuit sa itaas.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Ngayon ay pinapatakbo natin ang mthree sa ating backend para i-characterize ang assignment model na ginagamit sa measurement mitigation. Nire-rescale natin ang raw distribution gamit ang impormasyong iyon. Tandaan na minsan ay maaari itong magresulta sa napakaliliit na negatibong probabilidad (kaya ang terminong quasi-probabilities).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
Ang correction ng mthree ay gumagawa ng mga quasi-probability, sa halip na mga count. Maaari nating i-rescale sa mga count nang mano-mano. Kino-convert ng helper function sa ibaba sa mga count at nire-round sa mga integer na halaga. Gayundin, para sa malalaking circuit, magkakaroon ng maraming maling string na may napakakaunting count, ngunit nagpapagulo sa histogram. Tinatanggal ng pangalawang helper function sa ibaba ang anumang string na may mas kaunting count kaysa sa threshold na pipiliin natin, para magbigay ng malinaw na tanaw sa mga nangingibabaw na termino sa distribution.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Madali rin tayong makakagawa ng teoretikal, ideal na distribution kung saan pantay ang probabilidad ng all-zero at all-one na mga estado, at zero ang probabilidad ng lahat ng iba pang outcome, para sa paghahambing.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Sa wakas, maaari nating i-visualize ang ating mga resulta.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
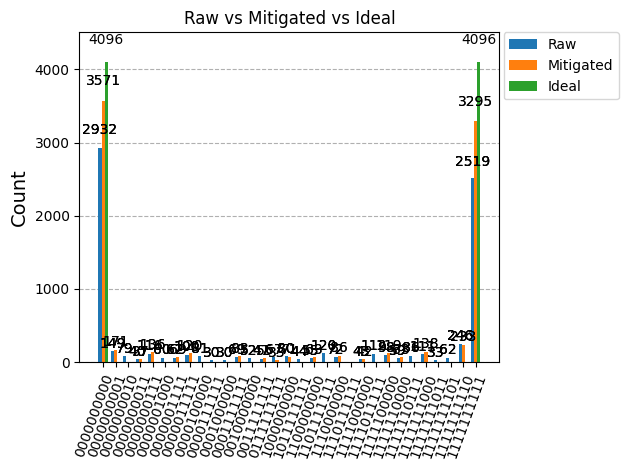
Mas malapit sa ideal na distribution ang mga mitigated na resulta kaysa sa mga unmitigated. Mas maisusukat natin ito gamit ang mga count para sa mga ideal na bitstring.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Pinahusay ng simpleng tool na ito ang ating fidelity ng 26% kumpara sa unmitigated na fidelity, na may medyo mababang overhead. Malinaw na maaaring maging napakahalaga ng M3. Ngunit pinili ang GHZ circuit bilang magandang use case, dahil mataas ang peak nito sa dalawang output state. Ang ilang problema ay nagreresulta sa mas pantay na distribusyon ng mga count (mga high-entropy state). Para sa napakalalalim na circuit na maraming qubit, madalas na magreresulta sa high-entropy state ang mga gate error at noise na walang kinalaman sa measurement error. Sa ganitong mga kaso, gumagana ang M3 sa isang state space na medyo malaki. May tatlong posibleng paraan dito:
(1) Tanggapin na ito ay limitasyon ng M3.
(2) Tandaan na ang upper bound sa espasyo ng matrix na binubuo ng M3 ay num_shots num_shots, sa halip na , kung saan mas maliit nang malaki ang una para sa malaking bilang ng qubit na .
(3) Nang may matinding pag-iingat lamang, alisin ang mga bitstring na napakababa ng probabilidad mula sa mga raw count na ipinapasok sa M3. Maaari itong magdulot ng bias, at ang paglilimita sa support ng iyong mga estado ay maaaring makagambala sa convergence sa mga pamamaraang tulad ng Krylov method. Dapat lamang itong gawin kapag alam mong eksakto kung bakit mo ito ginagawa at mahuhulaan mo ang lahat ng epekto nito. Kaya hindi built-in na feature ng M3 ang ganitong pag-trim.
Para sa higit pa tungkol sa mthree Qiskit addon, tingnan ang mga halimbawa, tagubilin sa pag-install, background, at API reference sa dokumentasyon nito.
Twirled readout error extinction (TREX)
Ang Twirled Readout Error Extinction (TREX) ay isang teknik ng measurement-error mitigation na ginagamit sa mga makabagong quantum computer. Layunin nitong alisin ang bias na dulot ng mga klasikal na readout error nang hindi nangangailangan ng buong characterization o inversion ng measurement assignment matrix.
Ang TREX ay hindi error correction at hindi nagpapabuti ng state fidelity. Sa halip, tinitiyak nitong unbiased ang mga expectation value estimator kaugnay ng readout noise, hanggang sa statistical error, sa pamamagitan ng pag-average sa mga randomized na measurement basis at pag-rescale. Sa IBM Quantum hardware, ang TREX ang default na mitigation method para sa expectation-value estimation at tumutugma sa resilience_level = 1 sa IBM Quantum Estimator primitive.
Kalikasan ng mga readout error sa superconducting hardware
Sa mga IBM superconducting qubit, nangingibabaw sa readout error ang:
-
Mga asymmetric na bit-flip probability (halimbawa, nang mas madalas kaysa sa kabaligtaran)
-
State-dependent na relaxation sa mismong pagsukat
-
Banayad ngunit hindi mapapabayaang crosstalk sa pagitan ng magkakalapit na readout resonator
Mahalaga, ang mga error na ito ay madalas na mamodelo bilang klasikal na stochastic process na kumikilos sa mga measurement outcome. Sinasamantala ng TREX ang isang karaniwang ideya mula sa noise tailoring: ang randomization (twirling) ng measurement procedure. Karaniwang dumadaan ang TREX sa dalawang yugto:
-
Twirling at klasikal na "untwirling"
-
Pag-rescale ng mga expectation value gamit ang mga calibration circuit
Ipagpalagay na ang expectation value ng observable na ay may kaugnayan sa mga noisy na tantiya, tulad ng sumusunod:
kung saan ang ay isang nakapirming salik na nag-scale sa tantiya at ang ay isang bias mula sa mga pinagmumulang inilarawan sa itaas. Ginagamit natin ang dito bilang paalala na readout error lamang ang tinutugunan natin dito; may gate error pa ring dapat isaalang-alang.
Bago lamang ang pagsukat, bawat qubit ay random na kino-conjugate gamit ang isang Pauli operator (tulad ng I o X). Pagkatapos ay klasikal na ina-untwirl ang mga measurement outcome.
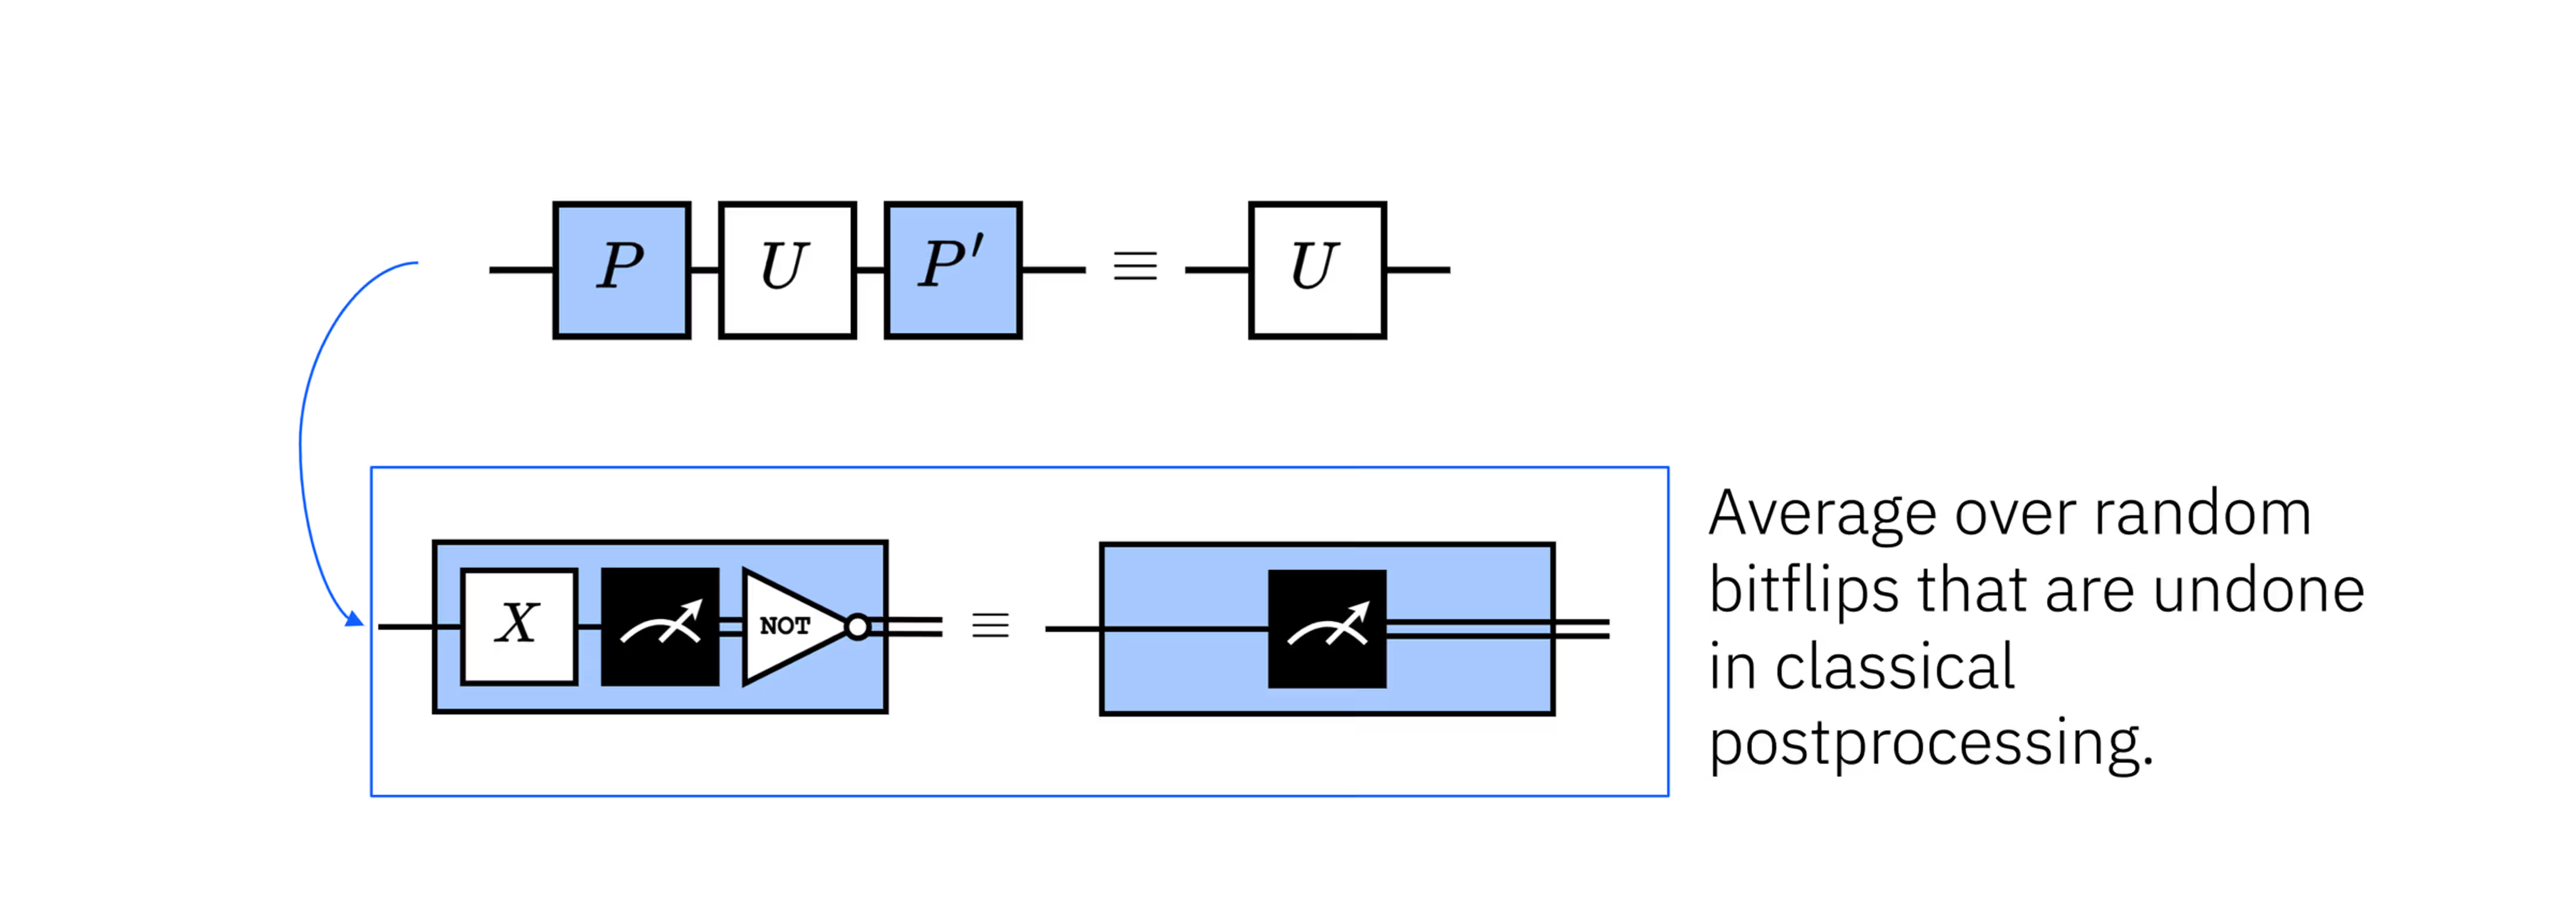
Ang pag-average sa mga randomization na ito ay nagsisimetriko sa readout channel. Bilang resulta, ang mga sistematikong asymmetry sa proseso ng readout ay ginagawang mas simetrikong error channel na ang natitirang epekto ay maaaring tugunan sa pamamagitan ng calibration at rescaling. Sa simpleng salita, kung halimbawa ay may bias patungo sa na estado, mawawalan tayo ng ilang pagsukat ng . Sa pag-twirl sa paligid ng pagsukat, random nating pinagpapalit kung aling logical outcome ang iniuugnay sa pisikal na proseso ng readout, at pagkatapos ay klasikal na ina-undo ang palitang iyon. Ang pag-average sa maraming ganitong randomized na pagsukat ay nag-aalis ng sistematikong pagkiling sa isang iniulat na outcome kaysa sa isa pa. Inaalis nito ang nangingibabaw na measurement bias sa ilalim ng mga pagpapalagay ng TREX model, kaya mayroon tayong:
Gayunpaman, maaaring kailanganin pa ring i-rescale ang mga expectation value. Ang ikalawang yugto ay ang paggamit ng mga calibration circuit (mga circuit na may kilalang outcome) para tantiyahin ang scaling factor na . Magagamit ito para makakuha ng lubhang pinahusay na tantiya.
Ang mga expectation value ng mga Pauli observable ay nagiging unbiased na estimator ng kanilang mga ideal na halaga. Walang tahasang noise model na pinag-aaralan o ini-invert, kaya numerically stable at mura ang TREX. Muli, hindi pa natutugunan dito ang gate error.
Sa pagtantiya ng expectation value na ng observable na , maaaring may variance dahil sa finite sampling, maaaring may maraming uri ng incoherent at coherent na error, at maaari ring may bias, , dahil sa readout error. Nagmumula ang bias na ito sa mga pinagmumulang tulad ng mga asymmetric na transition na tinalakay natin. Sa praktika, karaniwang mahusay na namomodelo ang bias na ito bilang klasikal na stochastic channel na kumikilos pagkatapos ng quantum evolution. Binabago ng TREX ang epektibong measurement channel para ang estimator ng ay unbiased kaugnay ng readout error. Medyo madali itong makita gamit ang pinakasimpleng halimbawa ng mga twirling gate: X. Kung may asymmetry sa kumpara sa , ngunit random nating pinapalitan kung aling estado ang binabasa (at ibinabalik sa klasikal na paraan pagkatapos), halatang inaalis nito ang sistematikong asymmetry (bagama't ang finite sampling ay nangangahulugan pa ring maaaring may bahagyang stochastic asymmetry sa pagsukat). Sa praktika, ang mga twirling gate para sa TREX ay hindi limitado sa I at X, ngunit sapat na ito para sa paliwanag.
Pinapayagan tayo ng TREX na makakuha ng tantiya ng expectation value na malaya sa bias dahil sa readout error. Maaari pa ring may bias mula sa ibang pinagmulan (tulad ng coherent over-rotation); readout lamang ang tinatarget ng TREX. Dahil pinapalitan ng TREX ang sistematikong bias ng randomized na symmetrization, karaniwan nitong kino-convert ang bias sa karagdagang stochastic variance, na nagpapataas ng variance ng estimator sa nakapirming sampling cost.
Suriin ang iyong pag-unawa
Ipagpalagay na gumagamit tayo ng estimator sa isang circuit na naghanda ng estadong sa pagtantiya ng . Ipagpalagay pa na ang mga measurement error ay nagiging sanhi para ang mga outcome na tumutugma sa ay maiulat bilang sa 10% ng pagkakataon, habang ang mga outcome na tumutugma sa ay naiuulat bilang sa 1% lamang ng pagkakataon. Ang asymmetry sa pagitan ng mga reporting error na ito ay nagdudulot ng measurement bias.
(a) Kung walang ganitong mga measurement error, ano ang magiging ideal na expectation value ng observable na ?
(b) Sa mga asymmetric na measurement o readout error, ano ang expectation value ng observable na ?
(c) Isaalang-alang ang limitadong hanay ng mga Pauli twirling gate: I at X. Ipagpalagay na ang I at X ay random na inilalapat na may 50% probabilidad sa maraming shot. Nalalapat pa rin ang parehong mga measurement error rate. Pagkatapos ay klasikal na ina-undo ang Pauli gate (I o X). Gumawa ng talahanayan ng lahat ng posibleng outcome at ng kanilang mga probabilidad dahil sa paunang superposition, mga asymmetric na measurement error, at random na itinalagang mga Pauli gate.
(d) Gamitin ang talahanayan para tukuyin ang expectation value na gamit ang twirling strategy.
(e) Ihambing ang mga expectation value: ideal, walang twirling, at may twirling.
(f) Ano ang nalaktawan sa pagtalakay na ito na matatagpuan sa isang buong aplikasyon ng TREX?
Sagot
(a) Maaari mo lamang gamitin ang intuwisyon at symmetry para sabihing . Para ipakita nang tahasan:
(b) Maaaring mag-collapse ang estado sa alinman sa o kapag sinukat, bawat isa ay may 50% tsansa. Ngunit sa 50% na nag-collapse sa estadong , 1% nito (o 0.5% ng lahat ng kaso) ay maling maiuulat bilang . Sa 50% na nag-collapse sa , 10% (o 5% ng lahat ng kaso) ay maling maiuulat bilang . Iniiwan tayo nito sa:
- 54.5%
- 45.5% Sa pagbalewala sa lahat ng iba pang uri ng posibleng error, makakakuha tayo ng tantiya na
(c)
| Pauli | Ideal na measurement outcome | Outcome pagkatapos ng Pauli | Readout error | I-undo ang Pauli | Pangwakas na iniulat na outcome | Probabilidad |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Wala | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Wala | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Wala | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Wala | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Mula sa mga naunang bahagi, alam natin ang mga expectation value ng Z sa bawat huling estado. Kailangan na lamang nating kunin ang weighted average:
(e) Sa napakasimpleng kasong ito, eksaktong naibalik ng paglalapat natin ng twirling ang ideal na expectation value. Hindi iyon karaniwan. Ang karaniwan ay inaalis ng twirling ang mga bias tulad ng mga ipinakilala ng asymmetric na transition, at nagbabalik ng expectation value na mas malapit sa ideal.
(f) Isa itong toy model na aplikasyon. Maaaring may ilang bagay na kulang. Kapansin-pansin, hindi tayo nagpatakbo rito ng mga calibration circuit para tantiyahin ang rescaling factor na . Karaniwang kinakailangan ito.
Mga detalye ng implementasyon
Awtomatikong inilalapat ang TREX kapag ginagamit ang EstimatorV2 primitive na may resilience_level = 1 (ang default). Tandaan na hindi ito awtomatikong inilalapat sa Sampler primitive, dahil ang Sampler ay nagbabalik ng buong probability distribution sa halip na mga expectation value.
Kapag naka-enable ang TREX, gumagawa ang runtime ng mga measurement-twirled na variant ng circuit sa pamamagitan ng pagpasok ng mga random na single-qubit Pauli bago mismo ang pagsukat. Binabaligtad ng klasikal na post-processing ang mga Pauli na ito. Random ang mga variant ng circuit na ito sa iba't ibang shot at gayundin sa iba't ibang qubit sa loob ng isang shot. Pagkatapos ay pinagsasama ang lahat ng variant ng circuit sa iisang estimator.
Napaka-scalable ng TREX. Nangangailangan ito ng mga karagdagang calibration circuit, kaya ang sampling overhead ay karaniwang maliit na constant factor (madalas 2-4x). Ngunit ang mitigation ay observable-specific, hindi distribution-preserving.
Dinisenyo ang TREX para madaling isama sa maraming pamamaraan ng error suppression at error mitigation, kabilang ang mga sumusunod:
-
Dynamical decoupling (DD) - kumikilos sa idle time, orthogonal sa readout mitigation.
-
Gate o Pauli twirling - madalas na komplementaryo; umaasa na ang TREX sa twirling ngunit readout noise lamang ang tinatarget.
-
Zero-Noise Extrapolation (ZNE) - tinatarget ng ZNE ang gate noise, habang ang TREX ang humahawak sa measurement bias. Ginagamit ang kombinasyong ito sa resilience level 2.
-
Probabilistic error amplification at probabilistic error cancellation sa mga workflow ng Estimator.
Gayunpaman, may ilang pamamaraang hindi maaari (o hindi dapat) isama sa TREX:
-
Sampler-level na probability correction: hindi nagbabalik ang TREX ng mga naitamang bitstring probability.
-
Post-hoc na mitigation sa data ng TREX na na-mitigate na: ang double correction ay maaaring magbalik ng bias.
Medyo tricky ang pagsasama ng TREX at ng assignment-matrix-based readout mitigation tulad ng M3. Ipinapalagay ng M3 na fixed ang measurement channel. Sinasadya ng TREX na i-randomize ang measurement, kaya nawawalan ng bisa ang assumption na ginagamit ng M3. Sa ganitong paraan, hindi basta-basta maisasama ang dalawang technique na ito. Gayunpaman, kung maglalapat ka ng measurement twirling habang nasa calibration na ginagamit sa M3, maaari mong magamit nang sabay ang approach na parang assignment matrix at ang twirling mitigation approach (kahit hindi eksaktong pareho ang twirling approach na ito sa TREX). Paulit-ulit itong tema sa pagsasama ng mitigation at suppression techniques: pumapalya ang bulag na pagdaragdag ng mga technique; kapag maingat silang pinagsama para "aware" sila sa isa't isa, gumagana ito at puwedeng maging malaking pakinabang.
Ang ginagarantiya lang ng TREX ay mga expectation value na walang bias dahil sa readout errors; hindi nito binabawasan ang variance, at hindi rin nito pinoprotektahan laban sa ibang uri ng bias. Tiyak na hindi nito naitatama ang lahat ng error. Gayunpaman, madalas itong malaking pagbuti, at magagawa ito sa mas mababang overhead kaysa sa ilang ibang method na kailangang matutunan ang buong noise models. Madalas ang TREX ang pinakamura at pinakamatatag na readout mitigation na magagamit, kaya mahusay itong default sa mga eksperimento.
TREX gamit ang Qiskit
Dito gagawa tayo ng simpleng two-qubit circuit, at gagamitin ang Estimator para tantiyahin ang expectation value ng isang napakasimpleng observable, ZX. Ang ideal na expectation value ay 1. Ikukumpara natin ang mga expectation value na may TREX at wala.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Gawin ang simpleng quantum circuit.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

I-transpile ang circuit gamit ang pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Ilapat sa observable ang parehong layout mula sa transpilation.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Patakbuhin ang eksperimento sa totoong quantum computer. Una, gagamitin natin ang reslience_level = 1; ito ang default, pero ginawa nating tahasan para maiba ang dalawang kaso.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Ngayon itinatakda natin ang resilience_level sa 0 para tumakbo nang walang TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Mas malapit nang malaki ang expectation value sa ideal (1) kapag may TREX, gaya ng inaasahan. Siyempre, iisang expectation value lang ito sa iisang qubit. Maghahanda tayo ngayon ng circuit na gumagamit ng non-Clifford gates at maraming qubit para subukin kung nananatiling matatag ang pagbuti ng TREX sa ibang setting.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Dito, walang espesyal sa rotation angle na . Pumili lang tayo ng kahit anong hindi pantay na superposition ng at para masuri ang epekto ng asymmetric na maling transitions at kung paano ito hinahawakan ng TREX. Sa state na ito, ang ideal na expectation value ng Z sa bawat qubit, kung walang anumang error (readout man o iba pa), ay:
Kaya umaasa tayong makakuha ng mga expectation value na malapit sa -0.924 sa lahat ng qubit. Titingnan natin kung pinapabuti ng TREX ang bawat expectation value nang isa-isa at kung pinapabuti rin nito ang average sa lahat ng qubit.
Subukin ang iyong pang-unawa
I-verify ang expectation value sa itaas sa pamamagitan ng direktang kalkulasyon.
Sagot
Nagta-transpile tayo gamit ang pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Ngayon gagawa tayo ng isang observable kada qubit para matantiya natin ang lahat ng dalawampung expectation value sa iisang workflow. Ibig sabihin, para sa na qubit, gusto natin ng observable na puro identity , maliban sa na posisyon, kung saan gusto natin ng . Tandaang ilapat din ang transpiled layout mo sa mga observable mo.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Ngayon puwede na tayong mag-execute. Gumagamit ang code cell sa ibaba ng session mode; kung wala kang access sa sessions, puwede mo itong palitan ng batch mode para patakbuhin ang parehong workflow pero may posibleng queue time sa pagitan ng mga circuit.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Dito ikinukumpara natin ang mean absolute errors na may TREX at wala.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
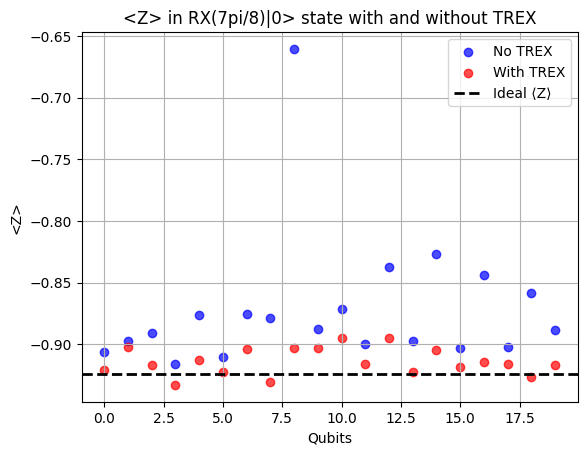
Mukhang talagang nakatulong ang TREX. Bumuti ang expectation value sa bawat qubit, maliban sa qubit 16. Inaasahan ang ganoong outlier. Mabibilang natin ang kabuuang epekto ng TREX sa circuit sa pamamagitan ng pagkuha ng mga average value.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
Sa karaniwan, inilapit ng TREX ang mga resulta natin nang mga 2.9% sa ideal na resulta, at iniwan tayo ng resultang, sa karaniwan, 0.4% lang ang pagkakaiba sa teoretikal na ideal. Magaling ito, at ito mismo ang dahilan kung bakit ang mababang-overhead na pagbuting ito ang default na error mitigation sa Estimator. Ngunit dapat nating idiin muli na inaalis ng TREX ang bias sa readout error, hindi itinatama ang lahat ng error natin. Pumili tayo ng initial state na malaki ang tsansang maapektuhan ng asymmetry sa readout. Iba sana ang epekto kung inihanda natin ang bawat qubit sa ibang state. Para sa simpleng argumento kung bakit kailangang ganoon, isipin kung ano ang mangyayari kung iniwan natin ang bawat qubit sa ground state na . Walang pagkakataong makita (o maitama) ang asymmetry sa readout error sa pagitan ng mga state na at .
Zero-noise extrapolation (ZNE)
Ang Zero-noise extrapolation (ZNE) ay isa sa pinakamalawakang ginagamit na error-mitigation techniques. Madali ring maunawaan ang pangkalahatang estratehiya, kahit masalimuot ang mga detalye ng implementasyon. Ganito gumagana ang ZNE:
-
Pagpapatakbo ng target circuit sa maraming "noise levels" — mga pagbabago sa circuit na nagpapalaki sa noise nito sa mga predictable na paraan
-
Pagtantiya sa observable na pinagtutuunan para sa bawat noise scale.
-
Pag-extrapolate pabalik sa zero noise gamit ang fitting model (linear, polynomial, exponential, at iba pa).
Ang resulta ay tantiya kung ano sana ang observable sa zero-noise limit na ipinahihiwatig ng extrapolation model.
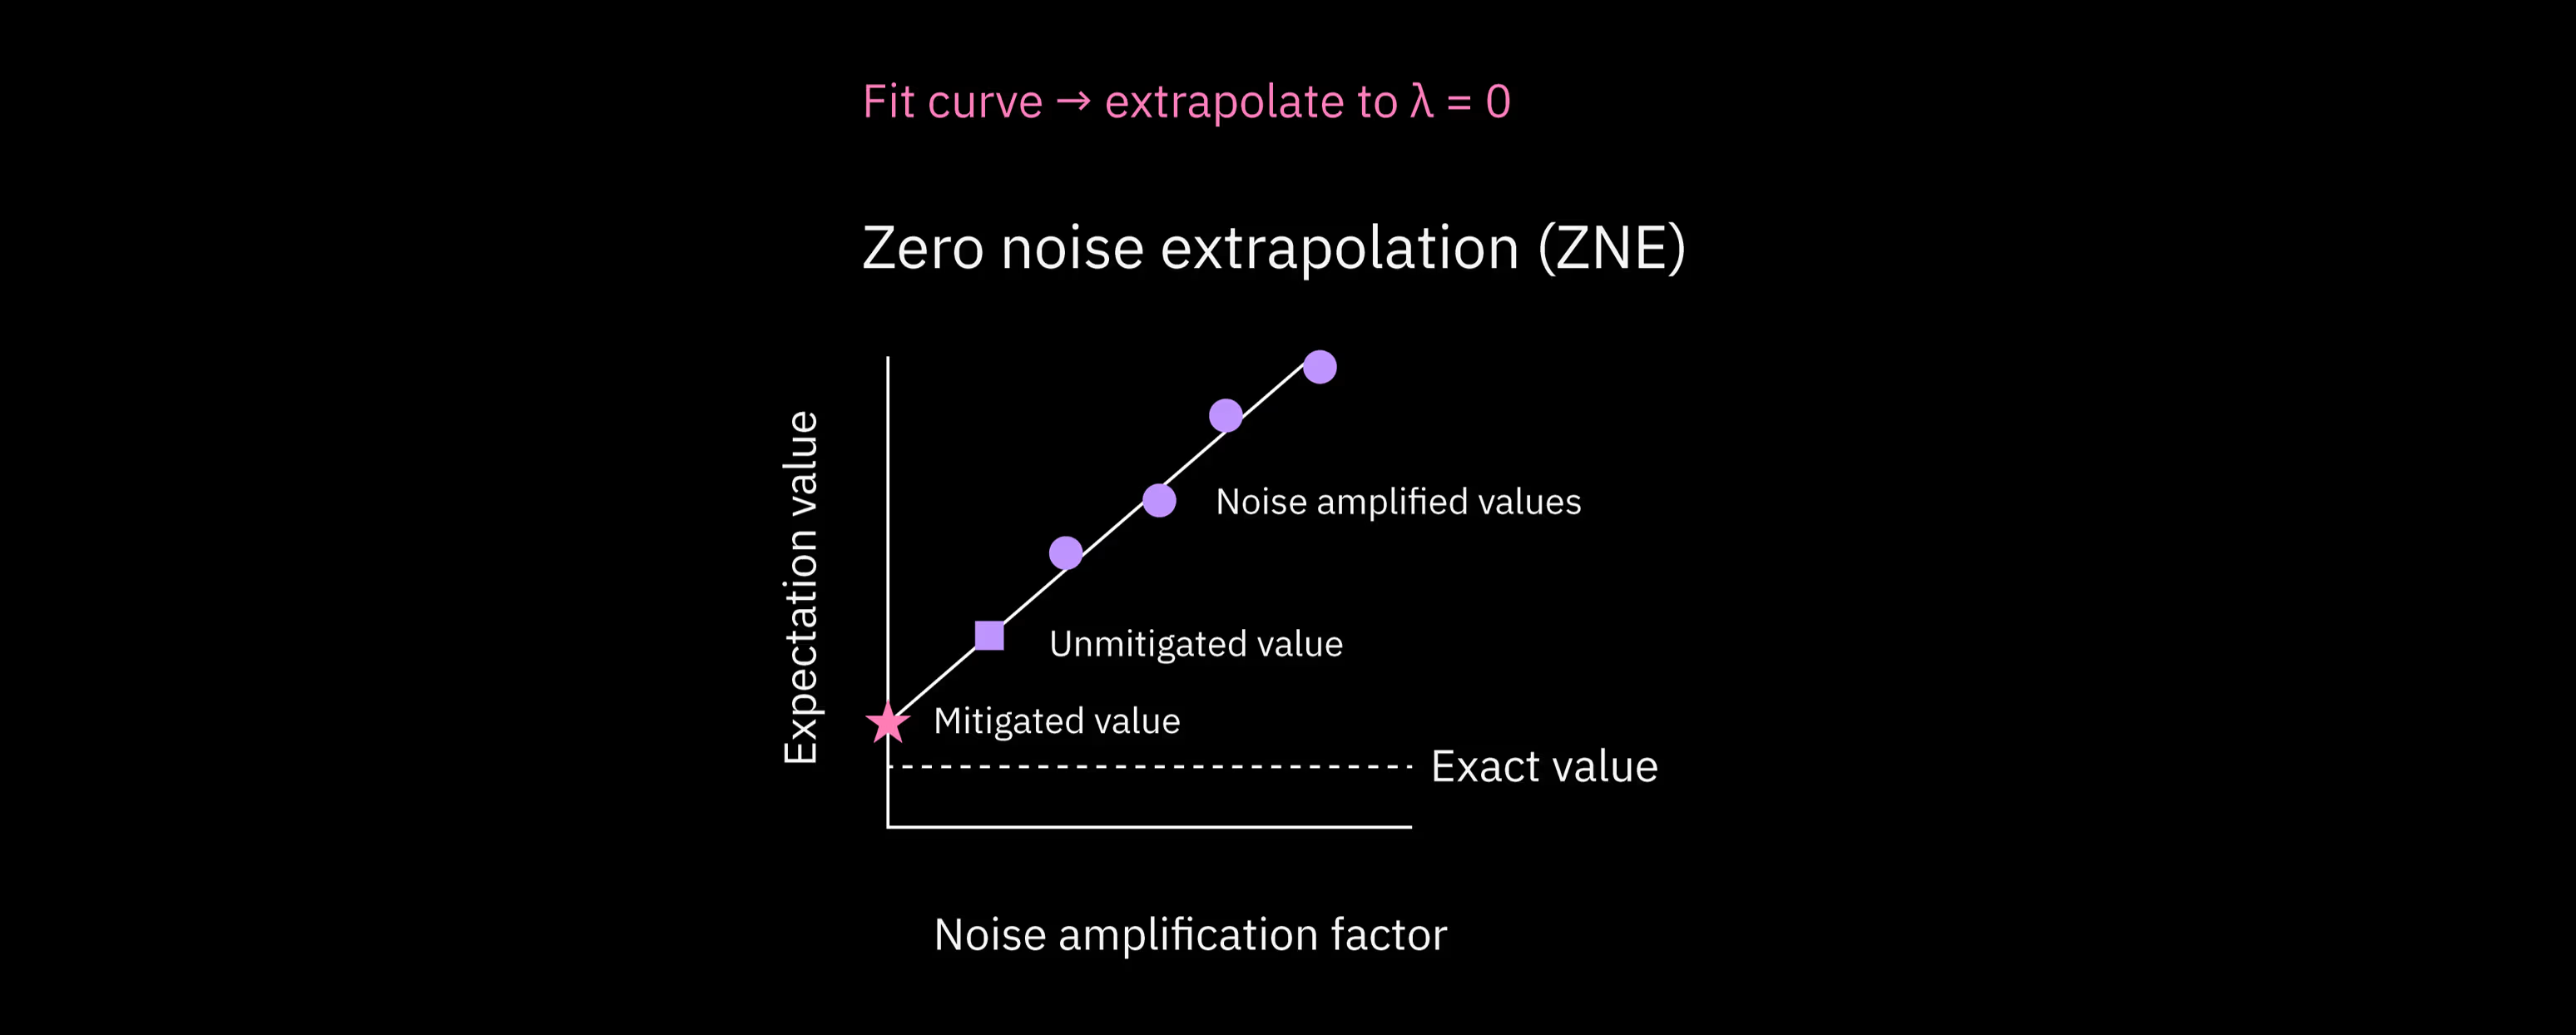
Hindi ginagarantiya ng ZNE na tataas nang maayos o linear ang noise habang binabago natin ang mga circuit. Sa halip, ipinapalagay nito na sapat na maayos ang pagkilos ng noise scaling para payagan ang extrapolation. Ang pagiging masalimuot ng ZNE ay nasa kung paano babaguhin ang mga circuit para matugunan hangga't maaari ang assumption na ito. Susuriin natin ang ilang approach sa lesson na ito.
ZNE resource scaling
Sa ZNE, ang overhead ay karamihan quantum overhead. Ibig sabihin, para makuha ang mga expectation value sa noise levels, kailangan mong isagawa ang eksperimento mo sa circuit, bawat isa ay maraming shots. Para mapanatili ang fixed na statistical precision, karaniwang tumataas ang kabuuang bilang ng samples habang dumarami ang mga noise-scaled circuit.
Ang bilang ng noise levels na susuriin mo, , ay nakadepende sa method na ginamit sa pag-scale ng noise. Para sa isang simpleng noise-scaling technique (tinatawag na "gate-folding", tatalakayin sa ibaba), karaniwang nasa pagitan ng 3 at 5 ang . Ang ibang method (probabilistic noise amplification (PNA)) ay nagpapahintulot ng non-integer na noise factors, at karaniwang nagreresulta sa mas mababang noise levels kaysa sa gate-folding. Ang kabuuang overhead ay lumalaki nang humigit-kumulang ayon sa:
kung saan ang ay ang baseline na bilang ng shots. Isa pang dapat tandaan: kung may paulit-ulit na gates ang noise scaling, maaaring tumaas ang circuit depth nang may factor na proporsyonal sa noise-scaling value. Ang pag-scale ng noise na kasabay ng pagtaas ng depth ang mismong layunin, pero bantayan ang kabuuang depth.
Angkop ang ZNE sa mga problemang kung saan totoo ang mga sumusunod na punto:
-
Kailangan mo ng general-purpose na mitigation method na epektibo sa maraming uri ng error.
-
Hindi masyadong malaki ang circuit depth; pumapalya ang ZNE kapag naging sobrang noisy na ang scaled circuit para i-extrapolate.
-
Kaya mong tanggapin ang katamtamang runtime overhead kapalit ng mas mataas na accuracy.
Sa praktika, dahil dito ideal ang ZNE para sa maraming variational circuit, expectation-value estimation, at iba pang near-term quantum algorithm. Naipapatupad ito sa Estimator gamit ang resilience_level = 2. Tandaan na nag-e-extrapolate ang ZNE sa isang space na may iisang outcome bilang function ng noise sa buong circuit. Ibig sabihin, angkop ito sa mga estimation problem, pero hindi sa mga sampling problem. Hindi ito idinisenyo para gumana sa mga distribution ng bitstrings.
Noise factors
Paano nga ba natin eksaktong maitataas ang antas ng noise sa isang circuit? May dalawang pangunahing paraan, bagaman maraming variant.
-
Palitan ang isang gate o block ng gates na ng . Dahil unitary ang mga gate sa quantum computers, alam nating kaya lohikal na: . Gayunpaman, bawat pag-uulit ng o ay nagdaragdag ng magkatulad o parehong error, kaya napapataas natin ang noise/error levels. Tandaan na ang pagpapalit sa itaas ay nagdadala sa atin mula sa orihinal na noise ng gate (noise level 1) tungo sa tatlong beses ng noise level na iyon sa (noise level 3). Sa praktika, maaari nating ulitin ang huling dalawang gate nang beses: para makakuha ng noise level na . Tinatawag itong gate folding, at napakakaraniwang noise scaling technique ito.
-
May iba pang method para itaas ang noise level, tulad ng probabilistic error amplification (PEA). Sa PEA, una nating pinag-aaralan ang angkop na noise model para sa circuit, karaniwang ipinapahayag bilang Pauli channel. Pagkatapos ay pinalalakas ang noise sa pamamagitan ng pag-sample mula sa rescaled na bersyon ng natutunang noise channel na ito. Sa pag-aayos ng sampling, tuloy-tuloy mong mai-scale ang epektibong lakas ng noise, kasama ang mga non-integer na halaga.
Sa praktika, napakapagkakatiwalaan ng gate folding sa pag-scale ng mga error, pero maaari rin itong humantong sa napakalalim na circuit. Kung tatlong noise levels lang ang kailangan mo (1, 3, at 5), ibig sabihin nito ay tataasan mo ang circuit depth nang 5 beses at makakakuha pa rin ng makatwirang resulta. Kaya, kung ang target circuit mo ay may transpiled na two-qubit depth na 60 o higit pa, malamang na mas bagay ang PEA kaysa sa gate-folding.
Maaaring i-fold ang mga gate nang lokal (ibig sabihin inuulit mo ang para sa bawat two-qubit gate sa sandaling mangyari ito), o maaari silang igrupo sa isang block ng gates at inuulit ang block (tulad ng mga gate na ). Madalas na mas gusto ang local folding para sa mga assumption ng ZNE, pero posible ang pareho.
Maraming nuance ang pagtrato sa istatistika ng mga noise-scaled na resulta sa ZNE. Halimbawa, sa limang beses ng noise level, tiyak na mas mataas ang variance ng mga resulta mo at mas hindi mapagkakatiwalaan. Dapat ba itong pantay na timbangin sa mga data point na mas mababa ang noise? Hindi. Gayunpaman, para makita ang ZNE sa aksyon, babalewalain natin ang ilan sa komplikasyong ito para sa isang toy model na eksperimento, kung saan bubuo tayo ng mga folded circuit nang mano-mano, at gagawa ng naive na extrapolation na may pantay na timbang para ilarawan ang mga pangunahing hakbang. Pero susundan natin ito ng eksperimentong gumagamit ng ZNE functionality na built-in sa Qiskit, at makikita nating mas mahusay nitong napangangasiwaan ang komplikasyong nilaktawan natin.
ZNE nang mano-mano
Magsisimula tayo sa pagpili ng quantum circuit at observable kung saan makakalkula natin ang ideal na expectation value kapag walang noise at error. Pinipili natin ang GHZ state na , na may even na bilang ng qubit. Ang observable natin ay . Pinipili natin ito dahil sa ilang dahilan:
- Napakadaling kalkulahin ang expectation value na sa ideal na kaso. Dahil even ang bilang ng qubit, makakakuha tayo ng
1mula sa bawat , pinarami nang magkakasama, o-1mula sa bawat , pinarami nang magkakasama nang even na bilang ng beses. - Medyo sensitibo ito sa error at noise, dahil ang iisang error sa isang qubit ay kayang baligtarin ang kabuuang outcome ng shot na iyon mula +1 tungong -1.
- Malayo sa 0 ang expectation value. Maaaring magkaproblema ang ZNE kapag napakalapit sa zero ng ideal na expectation value, dahil ang mataas na noise levels ay may tendensiyang i-randomize ang mga outcome, kaya kasing-dalas na positibo ang mga ito gaya ng negatibo. Ang resulta, ang mataas na noise values ay magbibigay ng mga halagang malapit sa ideal; maaari nitong gawing napakatricky ang extrapolation.
Sa motibasyong ito, buuin na natin ang mga circuit natin.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Pansinin ang subtlety na dito . Kahit na ang gate folding ay inilarawan bilang binubuo ng mga operator na may anyong , dito ang parehong istrukturang iyon ay mukhang CNOT CNOT CNOT.
Tiyakin nating ang na circuit natin ay talagang ang normal na GHZ circuit:
ghz_amp[0].draw("mpl")
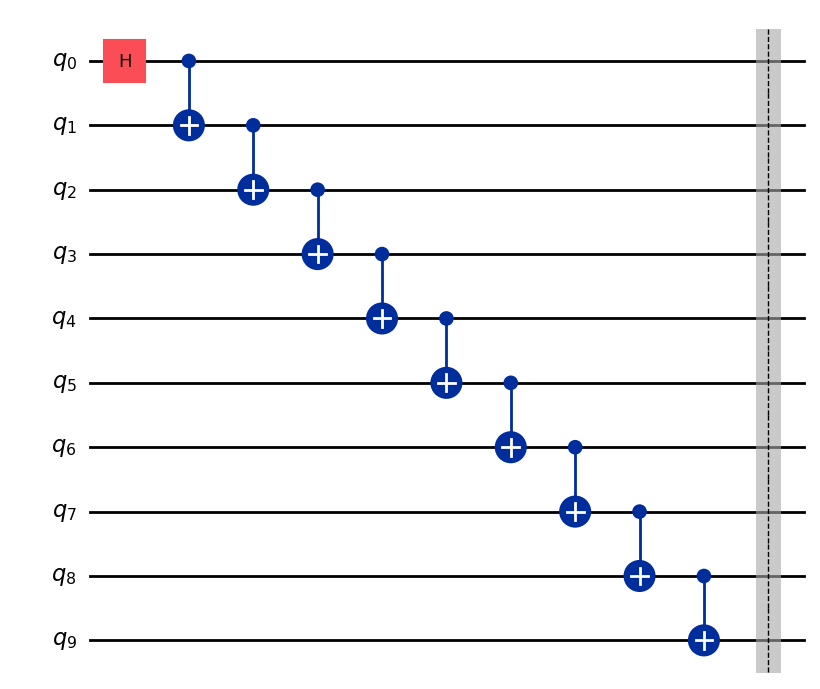
Puwede mong tingnan ang ibang mga circuit para i-verify na nasa inaasahang istruktura ang mga ito.
Ngayon bubuuin natin ang mga observable natin.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Gumagawa tayo ng pass manager at inilalapat ito sa mga circuit natin. Pagkatapos ay kinukuha natin ang mga layout at inilalapat ang mga ito sa mga observable natin.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
I-format ang pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Ngayon patatakbuhin natin ang Estimator. Gusto nating tumuon sa papel ng ZNE, kaya maaaring gusto nating itakda ang resilience_level = 0 para maiwasang mahalo ang mga epekto ng twirling sa epekto ng ZNE. Gayunpaman, gusto rin nating ikumpara ang "by-hand" na ZNE natin sa mga ZNE setting na built-in sa Qiskit, na may kasamang twirling. Kaya itinatakda natin dito ang resilience_level = 1. Ang pagtatakda ng resilience_level = 2 ay nag-i-invoke sa mga ZNE setting ng Qiskit, na gagamitin natin sa ilang sandali.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Ngayon ipi-print natin ang mga noise level at expectation value.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Ito ang bahaging pinakamapusok tayo: gumagawa tayo ng linear fit sa data na ito nang walang pagbibigay-pansin sa variance ng bawat halagang nakuha natin, at nang hindi sinusubukang hulaan nang teoretikal kung kailangang linear ang fit. Muli, mas mahusay ang ginagawa ng built-in na ZNE kaysa sa ginagawa natin nang mano-mano.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Ipi-plot natin ito bago ang interpretasyon.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
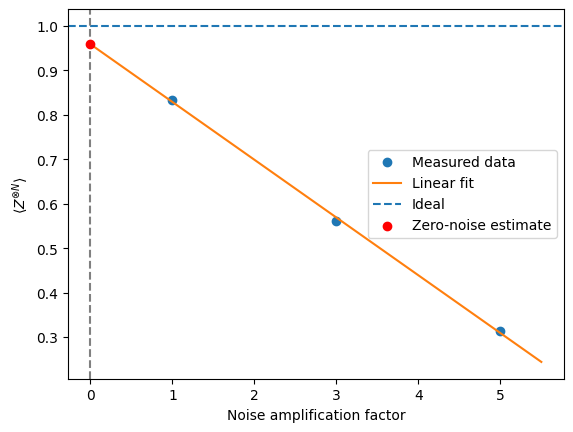
Sa paggawa ng lesson na ito, mula sa extrapolation papunta sa zero-noise na kaso, nakakuha tayo ng expectation value na 0.959. Maaaring iba ang mga halaga mo. Mas mahusay ito nang malaki kaysa sa expectation value ng raw circuit na 0.83, mga 13% na mas malapit sa ideal na halaga. Pero makikita mo rin na gumagamit tayo ng isang data point kung saan ang expectation value ay bumaba sa 0.31. Malinaw na mas mababa ang kalidad ng data point na ito. Kung mas mababa ang timbang na ibinigay sa data point na iyon sa linear approximation natin, at ang linya ay mas na-fit sa unang dalawang data point, makikita nating mas mataas sana (mas malapit sa ideal na halaga) ang zero-extrapolated na tantiya. Awtomatikong hinahawakan ang ganitong konsiderasyon sa ZNE na built-in sa Estimator.
ZNE na built-in sa Estimator
Ngayon tingnan natin kung ano ang mangyayari kapag ginamit natin ang ZNE functionality na built-in sa Estimator. Magsisimula tayo sa pagtukoy ng simpleng GHZ circuit, na walang gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Tinutukoy natin ang parehong observable gaya ng dati.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Muli tayong magtatakda ng pass manager, gamit ang optimization_level = 1. Babalikan natin ang pagpiling ito sa ibaba.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
I-transpile ang circuit at ilapat ang layout sa mga observable.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Pinatatakbo natin ang Estimator gamit ang ZNE at twirling, at ikinukumpara ang mga kinalabasan sa by-hand na implementasyon natin ng ZNE. Partikular, ikinukumpara natin ang mga ito sa resultang walang ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Makukuha natin ang mga halaga sa bawat noise factor gamit ang syntax na job_zne.result()[0].data.evs_noise_factors. Gaya ng dati, maaari nating gamitin nang naive ang mga resultang ito para makakuha ng linear fit at mag-extrapolate sa zero-noise na kaso, pero mas maayos na ang nagawa ng estimator na may resilience_level = 2, dahil isinasaalang-alang nito ang variance at iba pang konsiderasyon. Sa ibaba ipinapakita natin kung ano ang ibibigay ng linear extrapolation, at kung ano ang aktwal na ibinigay ng built-in na ZNE.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
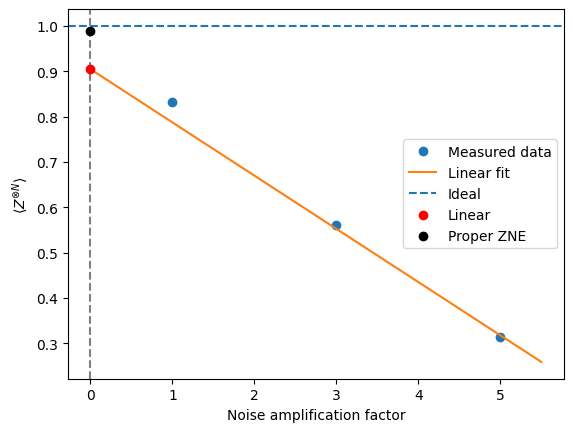
Nakikita nating pinabuti ng built-in na ZNE ang tantiya natin nang mahigit 15%, at mas mahusay nang malaki kaysa sa pagsubok nating gawin ito nang mano-mano.
Bago magpatuloy, tandaan na sa buong ZNE exploration na ito, itinakda natin ang optimization_level = 1 sa pass manager. Binabawasan ng mas matataas na level ng optimization ang error, at minsan ang pagbawas ng error ay nagpapahirap hulaan ang pag-scale ng mga error. Gaya ng madalas mangyari, may balanse: bawasan ang mga error, maliban kung sinasadya mo silang taasan nang may kilalang factor.
Pagsasama ng mga method
Umaasa ang ZNE sa mga sumusunod:
-
Isang malinaw na tinukoy na noise-scaling parameter na
-
Sapat na maayos at predictable na pag-scale ng mga expectation value kasabay ng
-
Parehong epektibong noise channel, sa magkakaibang lakas
-
Walang ipinasok na bias na hindi nag-i-scale kasabay ng
Maayos na naisasama ang ZNE sa mga technique na nag-aalis ng mga bias na hindi nag-i-scale (tulad ng M3) o ginagawang mas regular ang noise (tulad ng twirling), pero sumasalungat ito sa mga technique na sinusubukang kanselahin nang buo ang noise (PEC) o hubugin ito nang dynamic (DD).
Sa partikular, ang M3 ay tumutugon lang sa measurement/readout error, na sa praktika ay maaaring ituring na hiwalay sa mga gate error (na siyang pokus ng mga proseso ng error scaling sa ZNE). Halos independent ang M3 sa gate folding; maaari itong maayos na isama sa ZNE. Halos magkapareho ang TREX, at maaari rin itong isama sa ZNE.
Nakatuon ang Pauli twirling sa mga gate, hindi tulad ng M3 at TREX. Gayunpaman, tandaan na hindi direktang binabawasan ng Pauli twirling ang error/noise; sa halip, binabago nito ito para maging mas predictable. Maaaring makatulong ang Pauli twirling sa proseso ng ZNE dahil mas nagiging linear ang pag-scale ng mga gate error kaya mas tumpak ang extrapolation.
Mas may nuance ang Dynamical decoupling (DD). Dynamic na binabago ng DD ang pagkilos ng noise sa pamamagitan ng bahagyang pagkansela ng ilang error sa pagdaragdag ng mga gate sequence. Kung posibleng buuin ang mga circuit sa paraang pareho ang kilos ng DD kahit na naka-fold ang mga gate o block, sa prinsipyo ay maaaring pagsamahin ang ZNE at DD, pero sa praktika minsan nakakasagabal ang DD sa scaling. Kung gusto mong pagsamahin ang mga ito, kabilang sa mga dapat isaalang-alang ang sumusunod:
- Pare-pareho bang inilalapat ang DD sa lahat ng noise levels?
- Napapanatili ba ng folding ang istruktura ng DD?
- Monotonic pa rin ba ang kilos ng resultang noise scaling?
Ang huling error mitigation method na tatalakayin natin bilang standalone na approach ay hindi compatible sa ZNE: probabilistic error cancellation.
Probabilistic Error Cancellation (PEC)
Hindi tulad ng ZNE o measurement mitigation, sinusubukan ng PEC na kanselahin ang noise sa antas ng gate sa pamamagitan ng muling pagbuo ng ideal na channel sa expectation. Ang Probabilistic Error Cancellation (PEC) ang pinakamakapangyarihan at pinakamahal na error-mitigation technique na saklaw ng lesson na ito. Binuo ang PEC sa paligid ng tahasang inversion ng noise channel, na isinasagawa nang istatistikal sa halip na pisikal. Ganito gumagana ang PEC:
-
Pagtukoy sa noise model batay sa isang basis ng "error operations."
-
Pagpapahayag ng inverse ng noise channel bilang quasi-probability distribution sa mga pisikal na operasyon.
-
Pag-sample mula sa distribution na ito habang isinasagawa ang circuit para istatistikal na buuin ang unbiased na tantiya ng ideal na computation.
Sa konsepto, ang PEC ay parang virtual error correction — "binabawi" nito ang noise sa pamamagitan ng pagsasama ng mga noisy na operasyon sa maingat na tinimbang na random na mga pattern. Sa pamamaraan naman, hindi malapit na kaugnay ng error correction o detection code ang PEC. Ang unbiased na pagtantiya ng PEC sa ideal at noiseless na expectation value ay may kapalit na napakalaking sampling overhead at malakas na pagdepende sa tumpak na noise characterization.
Sa mga IBM quantum computer, pinakamainam tingnan ang PEC bilang precision tool kaysa general-purpose na mitigation layer: pinakaangkop ito sa maliliit na circuit o maliliit na bahagi ng mas malalaking circuit, mga benchmarking task, at mga high-accuracy na pag-aaral kung saan katanggap-tanggap ang mataas na quantum overhead.
Pagtukoy sa noise channel
Sa PEC, ang bawat ideal na gate sa isang quantum circuit ay minomodelo bilang isang ideal unitary channel na sinusundan ng noise process. Ipagpalagay na ang ang density matrix ng quantum state. Ang ideal na gate ay kinakatawan ng unitary matrix na , na lumilikha ng quantum channel:
Sa totoong hardware, sinisira ng noise ang ideal na ebolusyong ito. Minomodelo natin ang pisikal na implementasyon ng gate bilang isang effective noisy channel:
kung saan ang ay noise channel na kumakatawan sa mga stochastic error na kaugnay ng gate. Sa buong talakayang ito, ang , , at ay mga linear map na kumikilos sa density operators. Ang ideal na channel na ay unitary at reversible, habang ang noise channel na (at kaya ang ) ay isang completely positive, trace-preserving (CPTP) map.
Ipinapalagay ng PEC na kilala o halos kilala ang noise channel na . Sa IBM Quantum hardware, karaniwang nakukuha ang impormasyong ito mula sa device calibration data, mga error rate na hinuha mula sa benchmarking experiments, at mga pinasimpleng noise model tulad ng Pauli o depolarizing approximations para sa maliliit na gate set. Bagaman hindi kailangan ng PEC ng ganap na tumpak na noise model, mabilis na bumababa ang performance nito habang lumalayo ang ipinapalagay na noise channel sa tunay na kilos ng hardware.
Quasi-probability decomposition ng inverse noise channel
Ang pangunahing ideya ng PEC ay kanselahin ang epekto ng noise sa expectation sa pamamagitan ng pagbuo ng stochastic approximation sa inverse ng noise channel. Pormal, ang layunin ay maglapat ng linear map na humigit-kumulang bumabawi sa , upang:
sa expectation sa maraming circuit execution.
Ang inverse na ay tinutukoy dito bilang algebraic inverse ng na itinuturing na linear superoperator na kumikilos sa mga operator. Umiiral lang ang inverse na ito kung full-rank ang ; ang mga noise process na hindi invertible ay hindi eksaktong ma-mitigate gamit ang PEC.
Kapag posible ang inversion, ipinapahayag ng PEC ang inverse noise channel bilang linear combination ng mga pisikal na maipapatupad na operasyon:
Dito, ang bawat ay noisy na operasyon na maisasagawa sa hardware (karaniwang native gates o maiikling gate sequence), at ang mga tunay na coefficient na ay bumubuo ng quasi-probability distribution. Hindi tulad ng ordinaryong probabilities, ang mga coefficient na ay maaaring negatibo o lumampas sa 1.
Ang quasi-probability norm:
ay sumusukat sa gastos ng noise inversion. Para sa anumang nontrivial na noise channel, . Sa IBM Quantum hardware, karaniwang ginagawa ang decomposition na ito:
- kada gate o kada maliit na gate set,
- sa pag-aakalang restricted ang mga noise model (madalas Pauli-diagonal approximations),
- gamit ang mga backend-specific na native operation at scheduling constraint.
Monte Carlo reconstruction ng ideal na circuit
Para tantiyahin ang expectation value ng observable na , gumagamit ang PEC ng Monte Carlo sampling batay sa decomposition sa itaas. Para sa bawat paglitaw ng noisy na gate sa circuit, inilalapat ang sumusunod na pamamaraan:
-
Random na pumili ng operasyong na may probability:
-
Magtalaga ng classical weight:
-
I-execute ang resultang randomized noisy circuit sa quantum backend.
-
I-multiply ang nasukat na outcome sa product ng lahat ng naipong weight.
-
I-average ang mga weighted na resulta sa maraming circuit execution.
Ang resultang estimator na ay tumutupad sa
basta tumpak na inilalarawan ng noise model na ang hardware. Kaya ang PEC ay nagpapasok ng walang systematic bias sa expectation, ngunit pinapalitan ang bias ng malaking statistical variance. Bawat run ay gumagawa ng noisy pero weighted na tantiya; pagkatapos lang i-average ang maraming ganoong run lumilitaw ang ideal na expectation value.
Konseptwal na interpretasyon
Minsan inilalarawan ang PEC bilang virtual error correction. Bagaman hindi lubos na mali ang pananalitang ito, hindi ito dapat ipagkamali sa tunay na quantum error correction. Walang logical encoding, walang syndrome extraction, at walang real-time feedback sa PEC. Hindi napipigilan o naitatama ang mga error habang isinasagawa ang circuit.
Sa halip, kinakansela ng PEC ang noise nang istatistikal, sa pamamagitan ng pagsasama ng maraming noisy na circuit realization na may signed na classical weights upang magkansela ang mga error pagkatapos lang ng classical post-processing. Hindi pinoprotektahan ang impormasyon habang isinasagawa; muling binubuo ang mga ideal na resulta pagkatapos.
Resource scaling at gastos
Ang pangunahing gastos ng PEC ay nagmumula sa variance amplification. Ang variance ng PEC estimator ay lumalaki ayon sa:
na nagpapahiwatig ng:
Pundamental ang scaling na ito at hindi mapapabuti sa pamamagitan ng classical post-processing.
Para sa mga circuit na may maraming noisy na gate, bawat gate ay nag-aambag ng factor na , kaya humigit-kumulang multiplicative ang paglaki ng kabuuang quasi-probability norm:
kung saan ang ay ang circuit depth. Sa IBM Quantum hardware, karaniwang humahantong ito sa exponential na paglaki ng sampling cost kasabay ng circuit depth, na may partikular na malakas na sensitibidad sa mga two-qubit gate error. Nagtatakda ang scaling na ito ng mga praktikal na limitasyon sa applicability ng PEC.
Kasalukuyang praktikal lang ang PEC kapag natugunan ang isa o lahat ng sumusunod na kondisyon:
-
Napakaliit o mababaw ang mga circuit (madalas gates),
-
Simple at well-validated ang mga noise model (halimbawa, Pauli noise),
-
Katanggap-tanggap ang mataas na statistical cost,
-
Ang layunin ay accuracy kaysa throughput.
Dahil dito, madalas na inilalapat ang PEC sa:
-
Mga nakahiwalay na subcircuit sa loob ng mas malalaking workflow,
-
Mga hakbang ng short-time evolution,
-
Mga routine ng state preparation o measurement,
-
Mga eksperimento sa benchmarking at validation.
Makikita ito sa IBM software stack (IBM Quantum Compute at error-mitigation tooling), na tinatrato ang PEC bilang espesyalisadong opsyon, hindi default na mitigation layer.
Kabilang sa mga karaniwang use case ng PEC ang:
-
Precision benchmarking ng quantum hardware,
-
Beripikasyon ng maliliit na quantum algorithm,
-
Mataas na accuracy na quantum chemistry sa mga pinaliit na system,
-
Pag-cross-check ng ZNE o iba pang mitigation method.
Ugnayan ng PEC sa iba pang mitigation method
Maraming ibang mitigation technique ang isinasakripisyo ang accuracy kapalit ng scalability; kabaligtaran ang ginagawa ng PEC, na nakatuon sa accuracy higit sa lahat.
Dahil maaaring gamitin ang PEC sa isang subcircuit lang, lalong mahalagang itanong dito kung anong ibang mitigation method ang puwedeng pagsamahin dito. Para malinaw na maunawaan ang compatibility sa PEC, makakatulong na pangkatin ang mga technique ayon sa ginagawa nila sa noise. Isaalang-alang ang mga pangkalahatang kategoryang ito:
-
Noise cancellation - sinusubukang i-invert ang mga error channel
-
Noise scaling - sadyang pinapalaki ang noise para mag-extrapolate
-
Noise reshaping - binabago ang estruktura o spectrum ng noise
-
Bias removal - itinatama ang mga error na hindi nag-i-scale sa gate noise
Nasa kategorya (1) mismo ang PEC. Ang anumang method na nagbabago o nagre-rescale ng noise channel ay kailangang suriing mabuti.
Summary table (high-level)
| Technique | Compatible sa PEC | Mga Tala |
|---|---|---|
| ZNE | Hindi | Pag-undo laban sa pag-scale at minsan pag-tailor ng error |
| Pauli twirling | Oo (nang may ingat) | Nakakaapekto sa behavior ng error, pero maaaring mas madali itong matutunan |
| TREX | Oo | Walang overlap sa workflow. Ganap na compatible. |
| Dynamical decoupling | Karaniwang hindi | Binabago ang error channel |
Tinutugunan ng PEC at ZNE ang parehong pinagmumulan ng error (gate errors) sa pamamagitan ng mga assumption o workstream na hindi magkatugma, o pareho. Halimbawa, sa ZNE, ipinapalagay nating mapapalawak ang error sa isang parameter na :
at mabisang ma-scale ang error para i-model ang expansion na ito. I-u-undo ng PEC ang mismong error na inaasahan natin para sa scaling. Mawawalan ng saysay ang parameter na . Isa pang paraan ng pag-iisip dito:
-
Ang pag-apply ng ZNE bago ang PEC ay nagbabago sa noise channel na sinusubukan mong i-invert.
-
Ang pag-apply ng PEC bago ang ZNE ay inaalis ang mismong noise na inaasahan ng ZNE para mag-extrapolate.
Dapat ituring ang PEC at ZNE bilang magkahaliling error-mitigation paradigm, hindi mga composable na layer. Kapaki-pakinabang ang pagkumpara sa kanila nang magkatabi, pero hindi ang pagsasama sa kanila.
Karaniwang compatible ang PEC at Pauli twirling at madalas na kapaki-pakinabang. Maaaring makatulong ang twirling sa PEC dahil kino-convert ng twirling ang mga coherent error tungo sa stochastic Pauli error. Pinapasimple nito ang noise channel, kaya mas madali itong irepresenta at i-invert. Para sa PEC, napakahalaga nito dahil sa mga sumusunod na dahilan:
-
Mas simple ang mga quasi-probability decomposition para sa mga Pauli channel
-
Ang quasi-probability norm na ay madalas na mas maliit nang malaki
-
Nababawasan ang sampling variance
Maraming PEC demonstration ang nag-aassume o nagbi-build-in ng Pauli-twirled na noise. Mahalagang linawin na hindi nagmi-mitigate ng error ang Pauli twirling nang mag-isa; binabago nito ang hugis ng noise sa anyong mas mahusay na mahahawakan ng probabilistic error cancellation.
Puwede at dapat pagsamahin ang PEC at TREX. Ganap na compatible ang mga approach na ito at may magkahiwalay na papel. Sa measurement lang gumagana ang TREX, inaalis nito ang readout bias gamit ang randomized twirl ng measurement channel, at hindi nito naaapektuhan ang gate noise o ang circuit dynamics. Sa gate noise gumagana ang PEC. Dahil additive ang measurement error at hindi compositional, hindi ito nakadepende sa mga gate sequence. Ligtas, at madalas na kanais-nais, na i-apply ang TREX kasabay ng PEC.
Ang pagkakasunod-sunod ng mga method na ito ay ayon sa maaasahan mo:
- I-execute ang PEC-randomized na circuit
- I-apply ang TREX para i-mitigate ang readout error
- I-apply ang PEC weighting at averaging
Karaniwang hindi compatible ang PEC at DD maliban kung isinagawa ang noise characterization na ginamit para sa PEC habang aktibo ang DD. Ipinapalagay ng PEC na ang ay stationary, paulit-ulit, at tumpak na ma-characterize. Tahasang binabago ng DD ang hugis ng noise channel sa paglipas ng oras sa pamamagitan ng pag-modulate ng mga interaksyon ng system at environment at pagpapakilala ng mga non-trivial na pulse-timing effect. Bilang resulta, hindi pareho ang channel ng effective noise na may DD at wala. Mas pinapakumplikado pa ito ng katotohanang maaaring sensitibong nakadepende ang noise channel sa circuit scheduling. Ang kinalabasan ay nagiging ill-defined o invalid ang noise inversion.
Teoretikal na posibleng i-characterize ang noise habang aktibo ang DD at bumuo ng PEC model ayon dito, pero lubhang advanced ito at hindi kasalukuyang inirerekomendang workflow.
Manu-manong pag-apply ng PEC
Komplikado ang PEC at hindi inirerekomendang i-implement ito nang mano-mano. Gayunpaman, gusto nating daanan ang math ng isang basic na aplikasyon sa iisang qubit para maunawaan kung anong mga hakbang ang kasama sa proseso. Pumili tayo ng mixed pero nontrivial na state para malinaw nating makita ang mga numerical effect.
Kumuha ng qubit na dapat ay nasa pure state na
Ang ideal na density matrix ay:
Pinili natin ang density matrix na ito dahil hindi ito diagonal at para sa iisang qubit lang, kaya madaling suriin "nang mano-mano".
Ngayon ay mag-a-apply tayo ng napakasimple pero makatotohanang noise model: isang single-qubit depolarizing channel, na may maliit na lakas na .
Para maging madali ang arithmetic, kunin ang . Completely positive, trace-preserving (CPTP) ang channel na ito, gaya ng dapat. Isa itong makatotohanang noise channel para sa totoong hardware, o kahit man lang makatotohanan sa paglalarawan ng ilan sa noise. Bukod dito, analytically invertible ang noise channel na ito, bilang linear map. Sa madaling salita, may inverse matrix, pero hindi ibig sabihin nito na tumutugma ang matrix sa isang CPTP physical channel, at tiyak na hindi ito tumutugma sa isang unitary na maaaring i-implement sa hardware.
Ngayon ina-apply natin ang ating depolarizing noise channel sa ating single-qubit density matrix at nakukuha ang:
Kapag : at .
So:
Sa pag-apply nito sa ating state:
Kalkulahin nang tahasan:
Physical density matrix pa rin ito, at trace one pa rin — pero mas mixed na ito ngayon.
Ngayon ay kakalkulahin natin ang ideal na inverse channel, pero handang-handa sa posibilidad na maaaring hindi ito physical. Susuriin natin kung physical nga ito. Sa matematika, ang inverse linear map ay:
Kung ang inverse action na ito mismo ay isang valid na physical channel, matutukso tayong subukang i-implement ito nang eksakto. Siyempre, kailangan pa rin nating alamin kung paano ito i-implement gamit ang mga unitary operation at classical step, pero iyon ang magiging layunin. Gayunpaman, lumalabas na hindi ito CPTP, at sa pangkalahatan ay walang garantiyang magiging CPTP ang mga ganitong inverse mapping. Kritikal ito sa kasalukuyan nating talakayan, dahil ito ang dahilan kung bakit umiiral ang PEC.
Maaaring makita mong hindi ito CPTP sa pagtingin lang dito. Ang tiyak na paraan ng pagsuri ay i-apply ito sa isang density matrix at tingnan kung physical ang ibinabalik na resulta. Ito ay iniiwan bilang ehersisyo para suriin ang pag-unawa mo.
Suriin ang iyong pag-unawa
Suriin kung CPTP ang inverse mapping na mula sa itaas sa pamamagitan ng pag-apply nito sa isang bagong density matrix:
Bigyang-kahulugan ang mga resulta kung physical o non-physical ang mga ito.
Sagot
Bilang isang physical density matrix, tumutugma ito sa classical probability na higit sa 1 na nasa state na ang system at negatibong probability na nasa state na . Malinaw na maaaring magbunga ang mapping na ito ng mga walang katuturang density matrix. Bukod dito, sa pagsusuri ay makikita nating ang mga eigenvalue ng nagresultang density matrix ay 1.0625 at -0.0625, ibig sabihin hindi lahat ng eigenvalue ay positibo. Kaya hindi "completely positive" ang mapping, ang "CP" sa CPTP.
Suriin ang iyong pag-unawa
Suriin sa pamamagitan ng tahasang kalkulasyon na ina-undo ng inverse operation na sa itaas ang noise channel at ibinabalik ang noise-free na state.
Sagot
I-apply ito sa noisy na state:
Eksakto itong ang orihinal na state (hanggang sa rounding).
Inuulit natin para maging lubos na malinaw: hindi natin kayang i-invert nang eksakto ang noise channel; hindi CPTP ang inverse, at hindi rin ito valid na physical channel. Gayunpaman, mabisa nating ma-invert ang channel bilang linear combination ng mga physical channel.
Para sa depolarizing channel:
kung saan: at iba pa.
Ang inverse ay maaaring isulat bilang:
with:
-
= mga physically implementable na Clifford channel
-
= mga quasi-probability
-
Some
Ito ang pangunahing ideya sa likod ng PEC:
-
Mag-sample ng mga channel ayon sa ∣
-
Maglagay ng mga sign sa mga measurement outcome
-
Nagko-converge ang mga expectation value sa noise-free na halaga
Ina-apply natin ang PEC "nang mano-mano" sa pagtantya ng gamit ang density matrix na at tinitingnan kung mababawi natin ang mga resulta para sa . Para sa , inaasahan natin ang:
Pansinin din na para sa noisy na density matrix, nakukuha natin ang:
Tama ang order of magnitude pero malayo nang husto sa ideal na kaso.
Ngayon ay daanan natin kung paano, gamit ang proseso ng PEC, mare-reconstruct ang unbiased na expectation value mula sa noisy na density matrix. Sa totoong mga workflow, probabilistic ito at awtomatiko. Sa "by-hand" na workflow na ito, pipili tayo ng mga probabilistic na halaga na makatotohanan, pero marahil maginhawa para sa presentasyon natin. Hindi ito dapat ituring na pag-aangkin na perpekto ang PEC. Ipinapakita lang nito ang isang kapani-paniwalang senaryo na maaaring mangyari sa loob ng mga PEC package.
Tandaan na ang ating noise channel ay may anyong:
Ang inverse ay maaaring isulat (nang eksakto) bilang:
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Mas simple para sa introduksyong ito na tumuon sa epekto ng channel sa ating density matrix. Pinapayagan tayo nitong gumamit ng mga pamilyar na bagay gaya ng density matrix at expectation value. Para dito, isaalang-alang kung ano ang dapat totoo tungkol sa mga epekto ng inverse operation na ito sa ating estimation process: ang estimator na nagagawa ng PEC ay dapat normalized at unbiased. Tumutugma ito sa dalawang kondisyon:
-
Normalization: Para matiyak na hindi nagbabago ang scale ng observable sa operation na ito, kailangan nating . Para makita kung bakit ganito, maaari nating isaalang-alang ang aksyon ng inverse sa isang density matrix, o ang aksyon nito sa expectation value ng isang trivial na bagay gaya ng mismo.
-
Calibration: Sa totoong workflow, gumagamit tayo ng mga calibration circuit para matutunan ang noise behavior sa antas ng gate. Ginagamit natin pagkatapos ang kaalaman sa noise behavior sa antas ng gate, at ang linearity ng mga expectation value, para i-apply ang natutunang noise model sa mas malaking circuit. Sa ating kaso, nagsimula tayo sa artipisyal na kaalaman na ang ideal na expectation value ay . Pero napakadaling mag-isip ng state na alam nating teoretikal na ito ang ideal na halaga, at saka gumamit ng aktwal na mga measurement para sa calibration. Isang mahalagang punto na para sa PEC, karaniwang hindi natututunan ang buong noise model ng buong circuit. Sa halip, natututunan ang mga local noise model para sa mga indibidwal na gate o circuit layer at ginagamit ang mga iyon para buuin ang quasi-probability decomposition.
Ginagamit natin ang mga kondisyong ito para tukuyin ang at . Isaalang-alang ang ansatz na
and apply it to an arbitrary single-qubit density matrix .
Tandaan na ang mga Pauli channel ay kumikilos sa pamamagitan ng conjugation:
Ang pag-apply ng sa ay nagbibigay ng:
Sa pagkuha ng trace, nakukuha natin ang:
Unitary ang bawat Pauli operator, kaya pinapanatili ng conjugation ang trace:
Therefore,
Para maging normalized ang PEC estimator, dapat panatilihin ng effective inverse map ang trace ng lahat ng density matrix. Ibig sabihin, kailangan natin ng:
Ipinahihiwatig nito ang normalization constraint:
Pero sa ating kaso, nagbubunga ito ng kondisyong:
Ngayon ay gumagamit tayo ng calibration information para iugnay ang naobserbahang expectation value sa kilalang ideal na halaga.
Or equivalently,
Sa paglutas ng ating dalawang kondisyon para sa at , nakukuha natin ang:
Ang kabuuan ng mga coefficient na ito ay 1, pero isa sa mga ito ay negatibo.
Mababawi natin ang ideal na expectation value sa pamamagitan ng random na pagbabago sa circuit, pag-measure, pagpaparami ng resulta sa isang signed na weight, at pag-average. Sa partikular, walang density matrix na nire-reconstruct at walang inverse channel na pisikal na ini-implement.
Ang pangunahing hakbang: ito ang PEC
Para sa ating noise strength na , ang inverse channel ay maaaring isulat bilang:
Mahahalagang katotohanan:
-
Ang kabuuan ng mga coefficient ay 1
-
Isang coefficient ang negatibo
-
Ang bawat term ay physically implementable
-
Ang negativity ay lumilipat sa classical post-processing
Bumubuo tayo ng sampling distribution mula sa mga absolute value ng mga weight:
(para sa bawat isa sa X, Y, Z)
Kabuuang weight:
Para sa mga sampling probability, hatiin sa W.
| Operation | Probability | Sign |
|---|---|---|
| Walang gagawin () | 1.1875 / 1.375 ≈ 0.864 | + |
| I-apply ang X | 0.0625 / 1.375 ≈ 0.045 | - |
| I-apply ang Y | 0.0625 / 1.375 ≈ 0.045 | - |
| I-apply ang Z | 0.0625 / 1.375 ≈ 0.045 | - |
Ang sign ay galing sa orihinal na coefficient, hindi sa probability.
Binubuo ang bawat shot ng mga sumusunod na hakbang:
-
Ihanda ang state
-
Hayaang i-apply ng hardware ang noisy na circuit
-
Random na pumili ng operation mula sa table sa itaas gamit ang kaugnay na mga probability
-
Apply it
-
I-measure ang , na nagbibigay ng
-
I-multiply ang outcome sa
-
I-record ang numerong iyon
Gagawa na tayo ngayon ng mga halimbawa ng ilang shot.
Shot 1 (identity case)
Ipagpalagay na ang random na napili nating operation ay ang identity na (o kapareho nito: walang gagawin). Batay sa mga argumento at sa table sa itaas, mangyayari ito 86.4% ng oras. Dahil positibo ang coefficient ng sa inverse ng noise channel, pipiliin natin ang na sign. Madaling magbigay ang measurement natin ng Z ng alinman sa . Ipagpalagay nating ang lumabas.
Ang PEC-corrected na kontribusyon mula sa shot na ito ay:
Shot 2 (identity ulit)
Ipagpalagay na nakuha ulit natin ang bilang random na operation (kaya ang sign ng term ay una pa ring ), pero ngayon ang measurement natin ng Z ay nagbigay ng . Ngayon ang kontribusyon ay:
Shot 3 (napili ang X)
Sa pagkakataong ito, X ang random na operation natin. Negatibo ang term na ito sa inverse, kaya pinapanatili natin ang na sign. Ina-apply natin ang X at saka sinusukat ang Z. Muli, maaari tayong makakuha ng alinmang eigenvalue; sabihin nating ang nakuha natin. Ang kontribusyon mula sa term na ito ay:
Shot 4 (napili ang Z)
Z ang random na operation. Nagbibigay ito sa atin ng na sign mula sa table. Ipagpalagay na sinukat natin ang Z at nakakuha ng . Ang kontribusyon ay:
Shot 5 (napili ang Y)
Y ang random na operation. Nagbibigay ito sa atin ng na sign mula sa table. Ipagpalagay na sinukat natin ang Z at nakakuha ng . Ang kontribusyon ay:
Pag-average ng mga resulta
Isipin nating nangongolekta tayo ng maraming ganitong PEC-weighted na outcome:
Sa disenyo, ina-apply natin ang identity 86.4% ng oras. Ina-apply natin ang bawat isa sa iba pang gate 4.5% ng oras. Sa totoong workflow, hindi natin alam ang eksaktong pinagbabatayang mga state, ni ang buong noise channel. Pero alam natin ang weighting factor na mula sa itaas, at ang relatibong probability kung saan natin ina-apply ang bawat operation. Sa totoong workflow, umaasa tayo sa hindi alam na density matrix para magbigay ng mga measurement outcome. Ibe-verify natin dito na magbubunga ng tamang mga resulta ang prosesong ito.
Gusto nating kalkulahin ang average ng lahat ng weighted, signed na measurement kasama ang mga pag-apply ng mga Pauli operator na bago ang measurement. Tawagin ang kabuuang bilang ng lahat ng shot na . Tawagin ang set ng lahat ng shot kung saan in-apply ang Pauli na na at gamitin ang para i-index ang mga shot na ito. Tawagin ang measurement outcome ng na shot sa ilalim ng pag-apply ng na Pauli na . Maisusulat natin ang average na ito bilang:
Ang Pauli operator na ay ina-apply nang probabilistic na may probability na . Sa limit ng malaking bilang ng mga shot,
Magagamit natin ito para isulat ang:
kung saan ang ay ang expectation value ng Z sa ensemble lang ng mga shot kung saan in-apply ang . Kapaki-pakinabang ito dahil alam natin kung ano dapat ang bawat ganitong expectation value mula sa density matrix. Muli, sa totoong workflow, manggagaling ito sa measurement, hindi sa kilalang density matrix.
Suriin ang iyong pag-unawa
I-verify ang mga expectation value na sa itaas sa pamamagitan ng kalkulasyon o lohikal na pangangatwiran.
Sagot
Ang Y at Z ay magpapatuloy nang eksakto tulad ng nasa itaas.
Maaari na nating isulat muli ang kabuuang expectation value bilang:
Kung alam natin ang mga parameter na at para sa gate noise natin (o mas maraming parameter para sa mas komplikadong noise channel), sapat na iyon para matukoy ang (1) ang kabuuang weight factor, at (2) ang mga probabilidad kung saan dapat nating i-apply ang mga Pauli operator. Ipinapakita ng resulta sa itaas na kapag ginawa natin iyon, nababawasan natin ang noise at nababawi ang mga unbiased na expectation value. Ang average ng lahat ng shot na ito ay nag-converge sa , kahit na:
-
Ang bawat indibidwal na shot ay nagbibigay ng mga kontribusyong mas malaki sa ±1
-
Ang ilang shot ay may negatibong statistical weight
-
Pisikal ang bawat quantum operation
Pangkalahatang-ideya ng PEC workflow
Sa PEC, ito ang lahat ng hakbang sa quantum computer:
-
Noise learning
-
State preparation para sa target mong circuit
-
Mag-apply ng mga Pauli gate nang probabilistiko ayon sa inilarawan sa itaas
-
Measurement
Ang epektibong inverse noise map ay natutupad nang istatistikal sa classical post-processing. Pinapayagan nito ang mas pangkalahatang inversion ng mga noise channel na kung hindi ay mangangailangan ng mga hindi pisikal na hakbang tulad ng negatibong probabilidad.
Ang kapalit nito ay variance. Dati, ang bawat shot ay may "magnitude" na katumbas ng mga posibleng magnitude ng resulta ng measurement na . Pagkatapos i-scale gamit ang weight factor na , ang magnitude nito ay (1.375 sa halimbawa natin sa itaas).
Iyan ang pinagmulan ng sampling overhead ng PEC.
Built-in na PEC
Ngayon, gagamitin natin ang PEC na built-in sa mga IBM Quantum primitive. Mahalagang makilala rito ang pagkakaiba ng buong gate-level na PEC at ng local noise learning model para sa mas scalable na PEC, na siyang ginagamit ng mga IBM Quantum primitive. Ang overhead ng paggamit ng buong PEC ay maglilimita sa paggamit nito sa maliliit na circuit. Okay lang iyon, pero mas kapaki-pakinabang ang isang tool na kayang mag-scale sa laki kung saan nagiging mahalaga ang quantum computing para sa mga totoong problema. Dahil dito, gumagamit ang mga IBM Quantum primitive ng layer-wise na PEC gamit ang natutunang Pauli-Lindblad noise model, na may agresibong mga safeguard para sa scalability. Sa implementasyong ito ng PEC, natututunan ang noise bawat paulit-ulit na circuit layer, hindi bawat gate instance, at ang noise model ay Pauli-twirled, local, at Markovian. Ang mga Clifford gate ay sinasama sa noise model, habang ang mga non-Clifford gate ang nangingibabaw sa gastos ng mitigation. May limitasyon ang sampling overhead upang maiwasan ang exponential na pagsabog.
Ia-apply natin ang PEC na built-in sa mga IBM Quantum primitive sa dalawang sukat: maliit (anim na qubit) at katamtaman (30 qubit) para makita kung paano napapanatiling napapamahalaan ang gastos sa bersyong ito ng PEC. Sa bawat sukat ng eksperimento, tahasan din nating ihahambing ang mga resulta ng PEC sa mga walang mitigation, sa ZNE, at sa ideal na halaga.
Magsisimula tayo sa pag-import ng ilang kinakailangang package.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Pumipili tayo ng observable na ie-estimate. Ang observable sa ibaba ay ang Hamiltonian ng isang chain ng mga Ising-like na spin na may nearest-neighbor coupling lamang sa component ng kanilang interaksyon, at isang single-qubit term sa , na para bang dahil sa external field sa .
Walang espesyal na dahilan sa pagpili ng Hamiltonian na ito. Kailangan lang natin ng kombinasyon ng observable at circuit na hindi trivial para magawa ng error mitigation ang trabaho nito. Tahasan nating i-scale ang Hamiltonian (gamit ang mga coefficient), at hinahati natin sa bilang ng mga qubit para manatili ang energy sa parehong order of magnitude habang dinadagdagan natin ang bilang ng mga qubit. Magsisimula tayo sa anim lamang.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Tulad ng pagpili ng Hamiltonian, ang circuit para sa state preparation sa ibaba ay hindi pinili dahil sa anumang pisikal na dahilan. Sa halip, pinili ito para magkaroon ng sapat na two-qubit depth at sapat na dami ng mga non-Clifford gate upang maging kapaki-pakinabang ang PEC. Walang dahilan para isiping mahusay na approximation ng ground state ng chain ng mga spin na ito ang circuit na ito, halimbawa.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
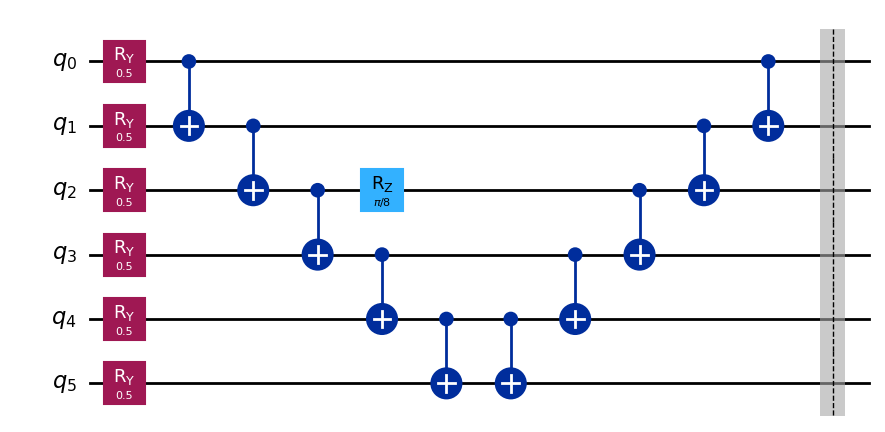
Ta-transpile natin ang circuit natin at ia-apply ang resultang layout sa mga observable natin.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Kinukuha natin ang ideal na expectation value gamit ang Statevector simulator.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Inaasahan nating magkakasinlaki ang iba pang ideal na halaga. Ngayon, patatakbuhin natin ito sa totoong IBM quantum computer nang walang error mitigation.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Ngayon, ia-apply natin ang ZNE sa parehong problema.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Panghuli, ia-apply natin ang PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Sa ibaba, ipi-plot natin ang mga resulta at ihahambing.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
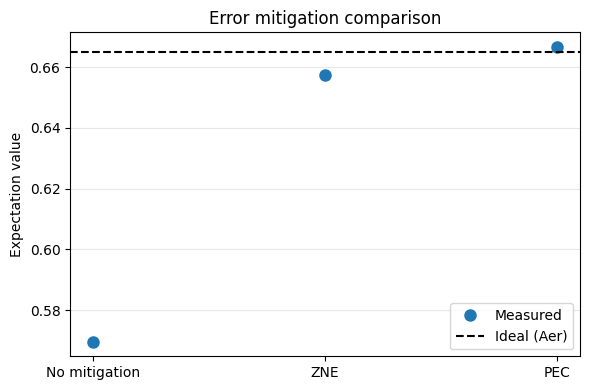
Napakahusay ng kinalabasan nito. Ang estimate natin gamit ang PEC ay 0.2% lang ang layo sa ideal na halaga.
Pero tandaan kung paanong exponential ang paglaki ng quantum overhead. Nagtakda tayo ng maximum na overhead na max_overhead = 100. Mula sa oras at sa kalidad ng mga resulta, mukhang maaaring hindi natin naabot ang maximum na iyon. Gayunpaman, kung palalakihin natin ang kalkulasyon at iiwan ang maximum na iyon, maaabot natin ito, at maaapektuhan ang mga resulta natin.
Makikita natin ang mangyayari kapag pinalaki natin ang circuit hanggang 30 qubit. Kapansin-pansin, sa maraming laptop ay magsisimulang mag-time out ang Statevector simulator sa paligid ng 24-28 qubit. Makakahanap tayo ng mga computational na paraan para malusutan ito. Pero sa halip, yakapin natin ang katotohanang makakalutas ang mga quantum computer ng ilang problema sa sukat na hindi kayang sabayan ng mga classical computer. Iyon ang punto. Ano ang magagawa natin, kung gayon, para i-validate ang mga resulta ng quantum computing natin sa mga ganoong kaso? Maraming posibleng sagot:
- Ang ilang problema ay mahirap lutasin pero madaling i-check (tulad ng prime factoring sa algorithm ni Shor).
- Ang ilang problema ay may mga parameter regime o bersyon na bumababa ang complexity at maaaring lutasin nang classical, o kahit analytical, para maihambing ang ilang punto. Sa kasong ito, pumili tayo ng Hamiltonian na intrinsic (hinati natin sa bilang ng mga qubit). Dapat medyo matatag ang ideal na expectation value. Tingnan natin kung paano nag-iiba ang ideal na expectation value ayon sa bilang ng mga qubit at kung makakagawa tayo ng mga classical na prediksyon tungkol sa halaga sa 30 qubit.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
Tunay ngang nakikita nating pumili tayo ng Hamiltonian at state na hindi nagbabago kasabay ng bilang ng mga qubit. Napakahina nitong gamitin para sa research application ng quantum computing, pero napakahusay para sa pag-benchmark ng mga error mitigation technique. Makakapagtiwala tayong gamitin ang nakapirming expectation value na ito bilang ideal na resulta, kahit na pinalalaki natin ang bilang ng mga qubit para sa pagsubok ng error mitigation.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Ngayon, patatakbuhin natin ang mas malaking circuit na ito gamit ang ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Panghuli, patatakbuhin natin ang 30-qubit na halimbawa gamit ang PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
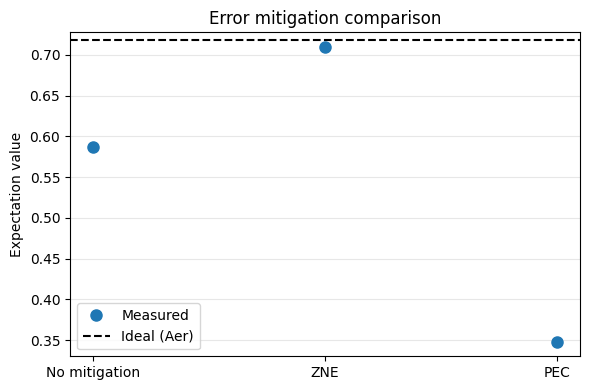
Hindi lang mas matagal ang PEC kaysa sa ibang opsyon, kundi malinaw ring naabot natin ang maximum na overhead threshold. Binayaran ng mga resulta ng PEC ang presyo ng overhead, pero pinigilan ng overhead cap ang sapat na tumpak na pagkansela ng natutunang noise model. Mahalaga ito. Sa anim na qubit, nagamit natin ang PEC at nakakuha ng mas magagandang resulta sa katamtamang pagtaas lang ng quantum overhead (humigit-kumulang 5 beses). Sa 30 qubit, mas mataas ang binayaran natin (humigit-kumulang 60 beses na mas mataas) at mas masama pa ang mga resulta kaysa sa unmitigated na estimate. Hindi ibig sabihin nito na hindi kailanman gagana ang PEC sa 30 qubit; maaaring nakadepende ito sa circuit. Ang mensahe ay simpleng nagpapahirap patakbuhin para sa malalaking circuit ang exponential na paglaki ng quantum overhead.
Mga pangunahing takeaway:
-
Madalas nakakatulong ang measurement mitigation at kadalasang mababa ang overhead nito: inaalis nito ang bias na hindi sumasabay sa circuit depth at malinis itong nakakasama sa halos lahat.
-
Hindi maaaring pagsamahin ang ilang technique. Kahit kapag maaari, tiyaking pinagsasama ninyo ang mga ito sa pare-parehong paraan upang hindi kinakansela ng isa ang isa pa. Magandang halimbawa ang pagtiyak na naka-on ang twirling habang nasa calibration para sa M3 kung pagsasamahin ang mga pamamaraang iyon.
-
Dapat ituring ang PEC at ZNE bilang mga alternatibo sa isa't isa. Nilulutas nila ang parehong problema na may magkasalungat na tradeoff:
-
PEC: nagbibigay ng mga unbiased na expectation value kapalit ng exponential na variance.
-
Karaniwang nagbibigay ang ZNE ng natitirang bias na nakadepende sa extrapolation model, pero sa katamtamang gastos.
-
-
Makakatulong ang DD sa mahahabang idle period, pero binabago nito ang hugis ng noise model at maaari nitong mapawalang-bisa ang mga assumption ng extrapolation o inversion.
-
Hindi binabawasan ng Pauli twirling ang noise. Binabago nito ang hugis nito at madalas nitong napapagana nang mas maayos ang ibang technique (ZNE at PEC).