I-refresh ang mga katangian ng backend gamit ang real-time na benchmarking
Tantya ng paggamit: 3 minuto sa ibm_kingston (TANDAAN: Ito ay tantya lamang. Maaaring mag-iba ang iyong runtime.)
Mga learning outcome
-
Kung bakit maaaring maiwan sa likod ng kasalukuyang behavior ng device ang mga property na iniulat ng isang QPU, at kung kailan sulit na muli mo itong sukatin
-
Kung ano ang sinusukat ng bawat isa sa limang standard na characterization experiment (readout, single-qubit randomized benchmarking, layered two-qubit randomized benchmarking, , at )
-
Kung paano patakbuhin ang buong characterization suite sa iisang tawag o hakbang-hakbang, at makakuha ng backend object na may na-refresh na mga property
-
Kung paano ihambing ang mga sinukat na property laban sa mga iniulat, at kung bakit ang ilang pagkakaiba ay sumasalamin sa methodology ng pagsukat sa halip na sa drift ng device
Prerequisites
-
Ang workflow ng Qiskit patterns
-
Mga execution mode ng Qiskit Runtime, lalo na ang batch mode
-
Kung paano galugarin ang impormasyon ng QPU, tulad ng mga property ng backend at calibration data
Background
Ang bawat IBM Quantum® QPU ay nag-uulat ng isang set ng mga property na naglalarawan kung gaano kaayos kasalukuyang gumagana ang bawat isa sa mga qubit nito: relaxation times (), coherence times (), readout errors, at one- at two-qubit gate errors. Ang mga numerong ito ay mahalaga sa praktika. Ginagamit ito ng transpiler upang magpasya kung anong physical qubit ang dapat patakbuhin ng iyong circuit, umaasa dito ang mga error mitigation technique, at maaari mo itong gamitin upang husgahan kung sapat na kaayos ang isang device para sa isang eksperimento.
Ang mga iniulat na property ay nagmumula sa mga calibration procedure na karaniwang tumatakbo minsan sa isang araw. Ang mga superconducting qubit, gayunpaman, ay maaaring mag-drift sa mas maiikling timescale, at ang mga transient defect (tinatawag na two-level systems) ay maaaring pansamantalang mapababa ang kalidad ng isang qubit na tila napakahusay noong panahon ng calibration. Bukod dito, ang isang job ay madalas na na-transpile nang matagal bago ito talagang mag-execute, kaya ang mga desisyong nakabatay sa mga iniulat na property ay maaaring nakabase sa lumang impormasyon. Ipinapakita ng tutorial na Real-time benchmarking for qubit selection kung gaano kalaki ang maaaring pag-iba-ibahan ng mga property na ito sa bawat araw, at bumubuo ng isang buong characterization workflow nang manu-mano mula sa mga indibidwal na Qiskit Experiments.
Ipinapakita ng tutorial na ito ang streamlined na bersyon ng workflow na iyon, sa pamamagitan ng paggamit ng BackendCharacterization utility mula sa Qiskit Device Benchmarking, na pinagsasama-sama ang pagbuo ng eksperimento, pagsusumite ng job, at curve fitting sa ilang tawag lamang. Gumugugol ka ng humigit-kumulang 70 segundo ng oras ng QPU at makakakuha ka ng backend object na ang mga property ay sumasalamin sa device ngayon mismo, handa nang ihambing sa mga iniulat na halaga o ipasa sa mga downstream na tool.
Ang mga characterization experiment
Sinusukat ng suite ang limang property, bawat isa ay may standard na eksperimento:
-
Readout error (
readout): Ang bawat qubit ay inihahanda sa o at agad na sinusukat. Ang probability ng pagbasa ng maling state ay nagbibigay ng state preparation and measurement (SPAM) error. -
Single-qubit gate error (
rb_1q): Ang Randomized benchmarking (RB) ay nagpapatakbo ng mga sequence ng random na single-qubit Clifford gate na sa ideal ay bumubuo sa identity. Ang paraan ng pagbaba ng survival probability habang tumataas ang haba ng sequence ay nagbibigay ng average error kada gate, independiyente sa mga SPAM error. -
Two-qubit gate error (
rb_2q): Ang parehong ideya ng RB na inilalapat sa buong layer ng non-overlapping two-qubit gate na sabay-sabay na isinasagawa, tulad ng sa isang eksperimentong layer fidelity. Dahil maraming gate ang tumatakbo nang sabay-sabay, ang resultang error rate ay kasama ang mga epekto ng crosstalk at mas malapit sa aktwal na naeeksperyensya ng isang malalim na circuit. -
(
t1): Ang bawat qubit ay pinasisigla at sinusukat pagkatapos ng lumalaking delay. Ang pagbaba ng excited-state population ay nagbibigay ng relaxation time. -
(
t2): Ang isang Hahn echo experiment ay naglalagay sa bawat qubit sa isang superposition, naglalapat ng echo pulse sa kalagitnaan ng isang delay, at sinusukat kung gaano kabilis nawawala ang phase coherence. Bilang default, ginagamit ang iisang echo; ipinapakita ang isang multi-echo (CPMG-style) na variant sa dulo ng tutorial na ito.
Ano ang ginagawa at hindi ginagawa ng pag-refresh
Tandaan ang tatlong punto kapag gumagamit ng workflow na ito:
-
Nasa backend object lamang na ibinalik sa iyo ang mga na-refresh na property. Walang nagbabago sa mismong device o sa calibration data na iniulat ng IBM Quantum sa ibang gumagamit.
-
Ang mga sinukat na halaga ay isang snapshot na kinuha gamit ang isang partikular na methodology. Ang ilan sa mga ito, lalo na ang layered two-qubit error at ang parallel single-echo na halaga, ay sinusukat nang iba mula sa iniulat na calibration data, kaya bahagi ng anumang pagkakaiba na iyong maoobserbahan ay methodological sa halip na drift. Itinuturo ng tutorial na ito kung saan ito nangyayari.
-
Ang characterization mismo ay nagkakahalaga ng oras ng QPU (humigit-kumulang 70 segundo para sa buong suite sa isang Heron r2 processor), na siyang presyo ng up-to-date na impormasyon.
Sinusunod ng workflow ang apat na hakbang ng isang Qiskit pattern:
-
Hakbang 1: I-map ang mga classical input sa isang quantum na problema. Piliin ang device at ang set ng mga property na susukatin.
-
Hakbang 2: I-optimize ang problema para sa pagpapatakbo sa quantum hardware. Direktang binubuo ng utility ang mga experiment circuit sa native gates ng device at pinararalel ang mga ito sa buong chip.
-
Hakbang 3: Mag-execute gamit ang Qiskit primitives. Tumatakbo ang mga eksperimento bilang Sampler job sa loob ng isang batch.
-
Hakbang 4: I-post-process at ibalik ang resulta sa nais na classical format. I-fit ang measurement data sa mga per-qubit error map, i-refresh ang backend, at ihambing ang mga sinukat na property laban sa mga iniulat.
Requirements
Bago simulan ang tutorial na ito, siguraduhing naka-install ang mga sumusunod:
-
Qiskit SDK v2.0 o mas bago, na may suporta sa visualization
-
Qiskit Runtime v0.40 o mas bago (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, na nag-i-install din ng Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Setup
I-import ang mga kinakailangang library.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
Ang characterization suite ay bumubuo ng ilang eksperimento, nagsusumite ng maraming job, at nagfi-fit ng mga resulta, na maaaring umabot sa ilang minuto sa kabuuan. I-enable ang INFO-level logging upang i-print ng bawat stage ang progreso nito habang nangyayari ito.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Halimbawa ng simulator sa maliit na sukat
Hindi kasama sa tutorial na ito ang isang simulator example. Sinusukat ng workflow ang mga physical imperfection ng isang tiyak na device: kung gaano kabilis nag-relax at nag-dephase ang mga qubit nito, at kung gaano kadalas nabibigo ang mga gate at readout nito. Walang alinman sa mga imperfection na ito ang isang ideal na simulator, kaya walang dapat i-characterize. Maaari kang maglagay ng synthetic noise model sa isang fake backend, ngunit makakakuha lamang ang mga eksperimento ng mga numerong ikaw mismo ang naglagay. Dahil dito, direkta tayong magpapatuloy sa hardware, na hinati sa apat na hakbang ng isang Qiskit pattern.
Halimbawa sa malaking sukat na hardware
Step 1: I-map ang mga classical input sa isang quantum problem
Sa workflow na ito, ang "problema" ay ang device mismo: ang classical input ay ang QPU na nais mong i-characterize at ang listahan ng mga property na susukatin, at ang quantum na mga eksperimento ay ang mga characterization circuit na nabuo mula sa mga ito.
Una, pumili ng backend. Ginagamit ng tutorial na ito ang ibm_kingston, isang 156-qubit na Heron r2 processor; maaari kang pumalit ng anumang IBM Quantum device na mayroon kang access (o pumili ng isa gamit ang service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Susunod, piliin kung aling mga properties ang susukatin. Maaari kang magpasa ng anumang subset ng mga sumusunod na eksperimento:
-
readout: SPAM (state preparation and measurement) na eksperimento -
rb_1q: nakahiwalay na single-qubit randomized benchmarking -
rb_2q: sabayang two-qubit randomized benchmarking mula sa layer fidelity na eksperimento -
t2: Hahn echo na eksperimento (iisang echo bilang default) -
t1: relaxation na eksperimento
Patakbuhin ang buong suite para makakuha ng kompletong larawan ng device; alisin ang mga entry sa listahan kung mga ilang properties lang ang mahalaga sa iyo at gusto mong makatipid ng oras ng QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Step 2: I-optimize ang problema para sa pagsasagawa gamit ang quantum hardware
Sa karamihan ng mga tutorial, dito karaniwang ini-transpile ang mga circuit. Dito, ang BackendCharacterization ang bahalang gawin iyon sa loob. Binubuo nito ang mga experiment circuit nang direkta sa native gates ng device, pinapatakbo ang single-qubit experiments sa lahat ng qubit nang sabay-sabay, at itinatakda ang two-qubit benchmarking sa magkakahiwalay na layer ng coupling map para masakop ang buong device gamit lang ang ilang jobs. Dahil sa parallelization na ito, ang buong suite ay umuubos lang ng humigit-kumulang 70 segundo ng oras ng QPU.
I-initialize ang class na namamahala sa workflow:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Step 3: Isagawa gamit ang Qiskit primitives
Ang run_experiments method ang bumubuo ng mga circuit at isinusumite ang mga ito bilang mga Sampler jobs. Patakbuhin ito sa loob ng Batch context para maka-schedule ang mga job nang magkakasama sa QPU, at nagbabalik ang method kapag naisumite na ang lahat ng jobs. (Maaari mo rin itong patakbuhin sa labas ng batch, o sa loob ng Session.)
Maaaring makakita ka ng warning tungkol sa isang backend na ipinapasa habang bukas ang session context manager. Inaasahan ito at ligtas lang balewalain.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Ibinabalik ng method ang mga naisumiteng jobs bilang dictionary na naka-key ayon sa eksperimento, na kapaki-pakinabang para sa pagsubaybay sa mga ito sa IBM Quantum Platform dashboard o para sa debugging.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Step 4: I-post-process at ibalik ang resulta sa nais na classical format
Suriin ang mga resulta
Ang analyze_results method ay naghihintay para matapos ang mga job at ini-fit ang measurement data: exponential decay para sa at , survival-probability decay para sa mga RB experiment, at assignment matrices para sa readout. Nagbabalik ito ng dictionary ng error maps, isang entry bawat sinukat na property, bawat isa ay nagmamapa ng qubit (o pares ng qubit) sa sinukat na halaga nito.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Sinasaklaw ng mga map ang readout error, ang single-qubit x at sx gate errors, ang layered two-qubit errors (lf_error_map, mula sa layer fidelity na eksperimento), at ang mga oras ng at sa segundo.
I-update ang mga backend property
Isinusulat ng update_backend method ang mga sinukat na halaga sa mga property ng kopya ng backend at ibinabalik ito. Pinapanatili ng orihinal na backend object ang naiulat na calibration data, para maikumpara natin ang dalawa, gaya ng ipinapakita sa ibaba. Tandaan na ang update na ito ay lokal lang sa iyong Python session; hindi ito nagbabago ng anuman sa device o para sa ibang users.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Ikumpara ang mga sinukat na property sa mga naiulat na property
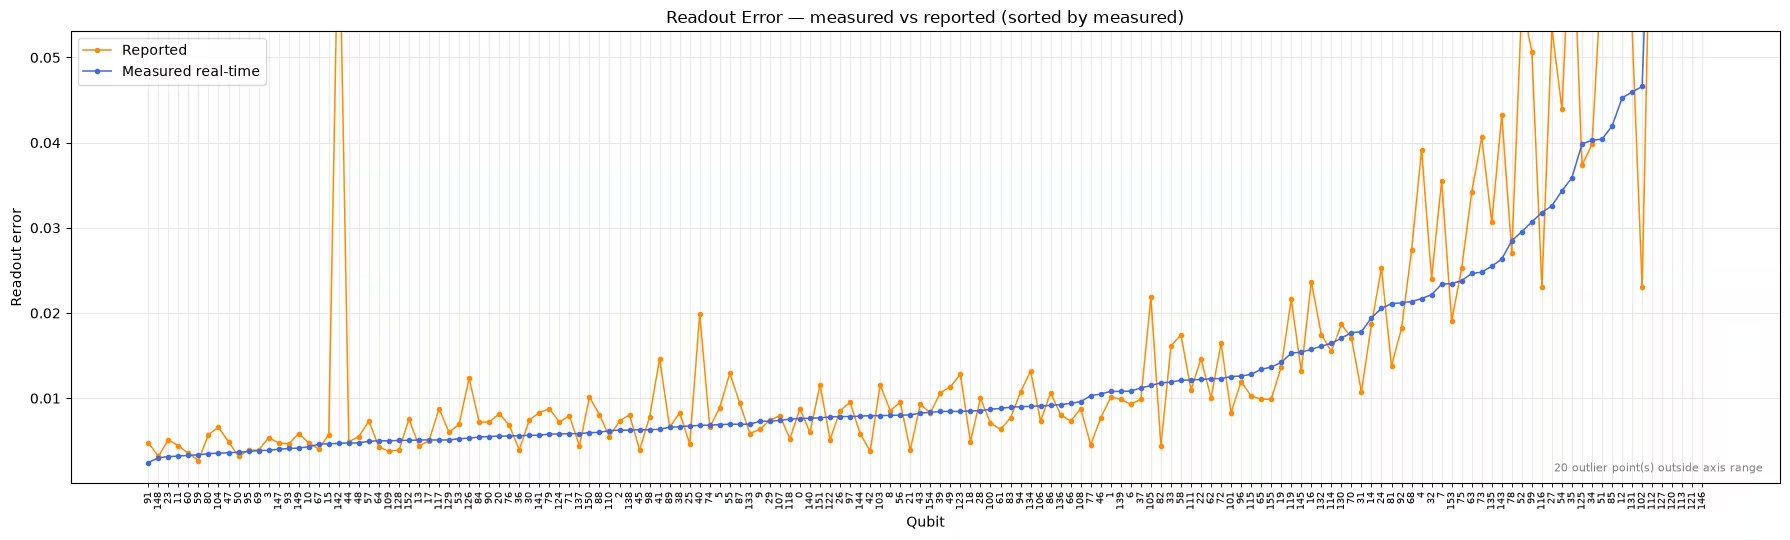
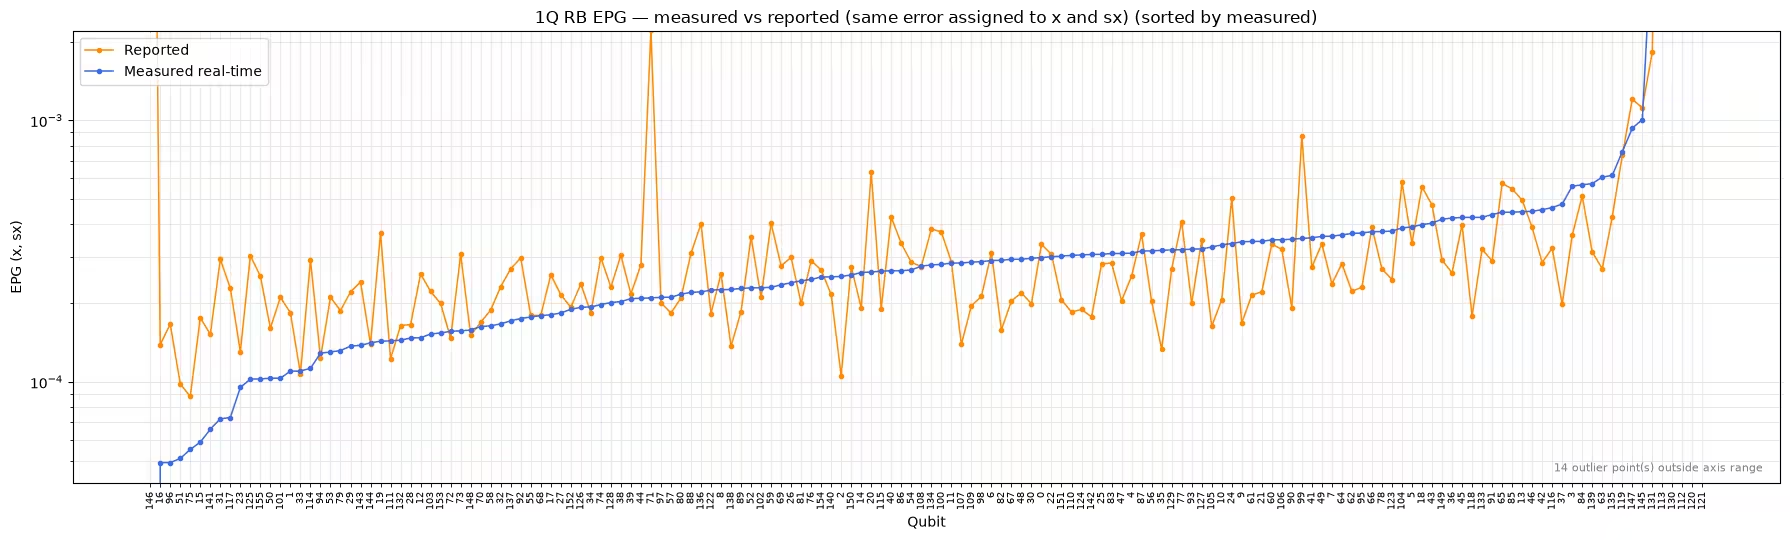
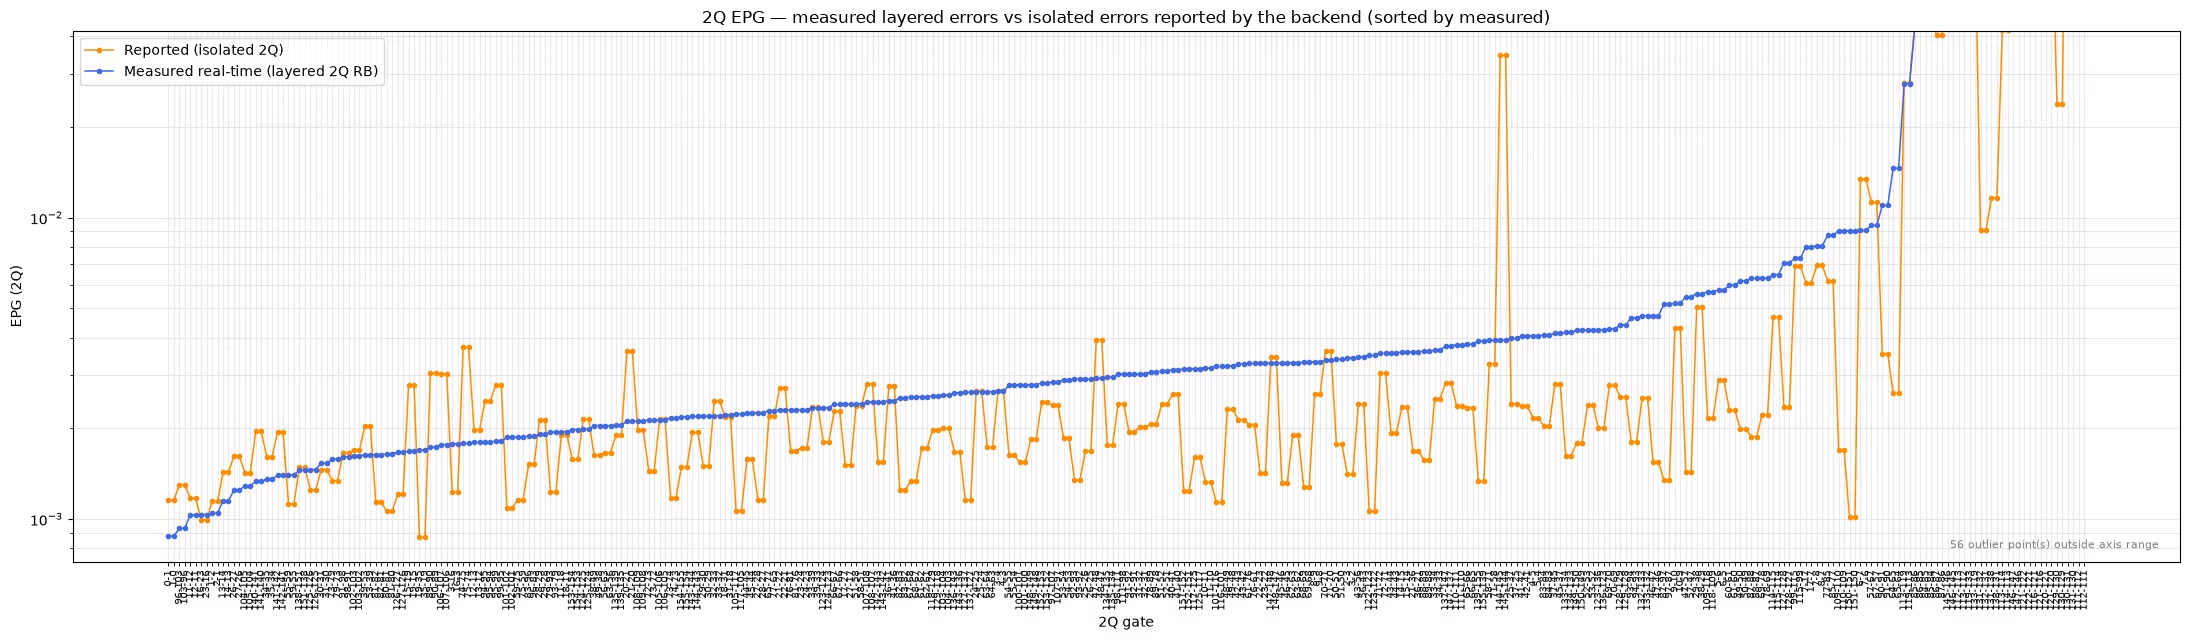
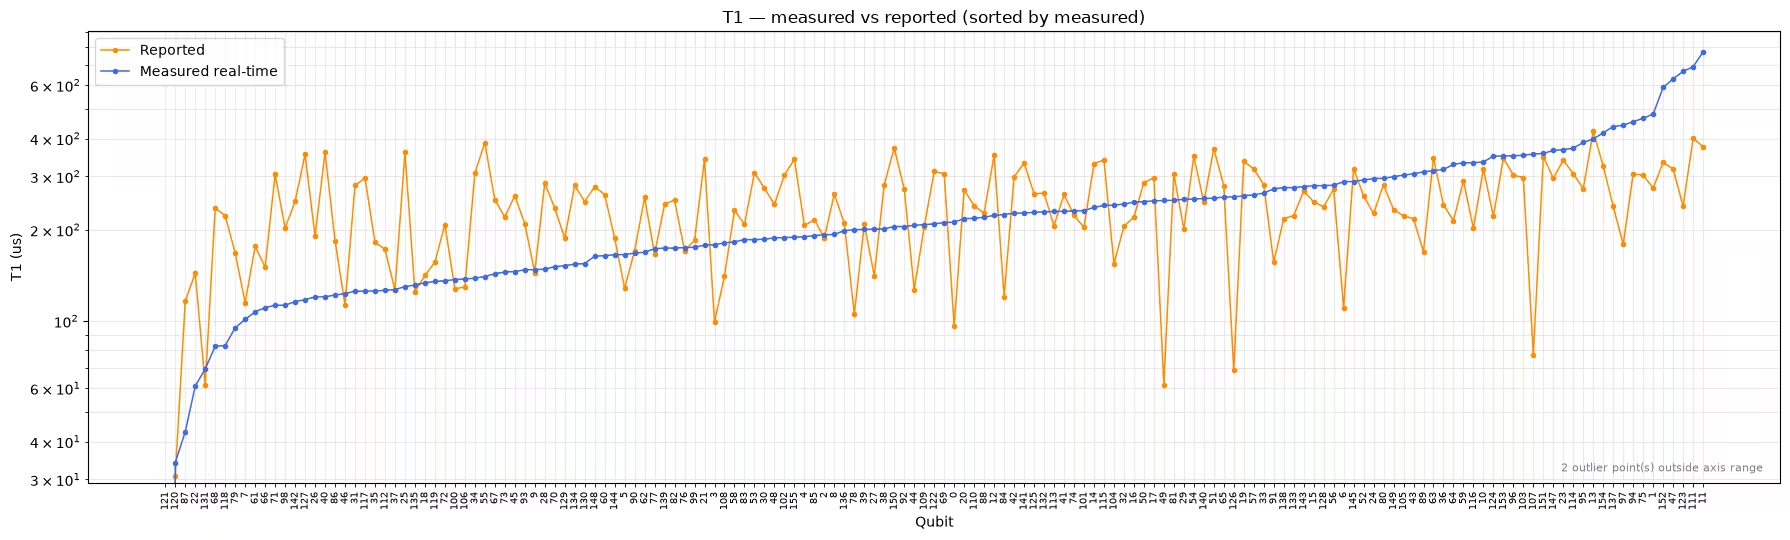
Sa wakas, i-plot ang mga sinukat na real-time property laban sa mga halagang iniulat ng backend. Sa bawat panel, ang mga qubit (o pares ng qubit) ay pinagsunod-sunod ayon sa sinukat na halaga, kaya smooth ang measured curve dahil sa construction nito at ang scatter ng mga naiulat na halaga sa paligid nito ay nagpapakita kung saan hindi magkatugma ang dalawa. Isang plot lang ang ipinapakita para sa single-qubit RB dahil ang parehong sinukat na error kada gate ay itinatalaga sa parehong x at sx gates. Ang axis limits ay pinipili mula sa bulk ng data para hindi ma-compress ang mga plot ng ilang extreme outlier; ang anumang punto sa labas ng range ay binibilang sa isang annotation sa plot (o ipasa ang ylim para i-override ang mga limit).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
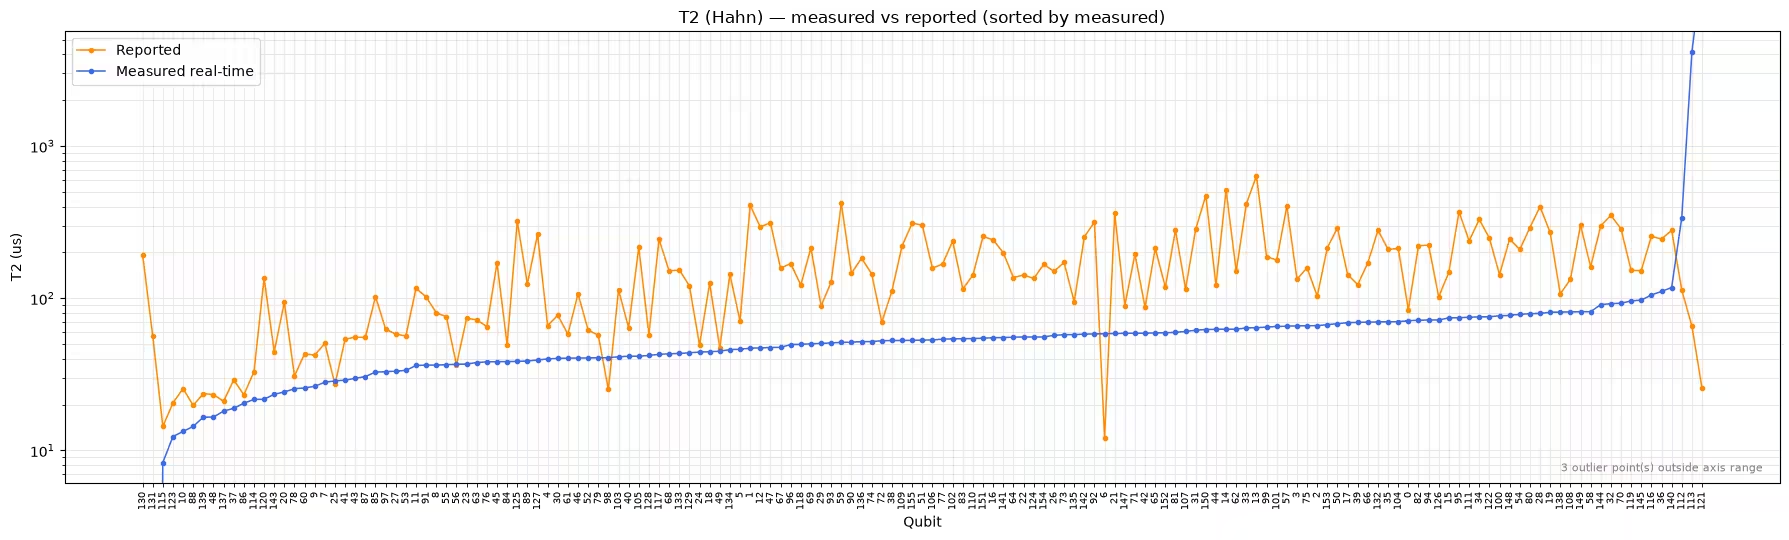
Ang mga plot na ito ay nangangailangan ng maingat na pagbabasa, dahil hindi lahat ng puwang sa pagitan ng dalawang curve ay nangangahulugan na nag-drift ang device:
-
Readout at single-qubit errors: Sinusundan ng mga sinukat na halaga ang mga naiulat sa karamihan ng mga qubit, habang ang naiulat na halaga para sa ilang qubit ay lubhang malayo sa measured curve. Ang mga naka-localize na hindi pagtutugmang iyon ang drift na dinisenyo ng workflow na ito para mahuli.
-
: Ang dalawang set ng data ay nag-scatter sa paligid ng isa't isa nang walang systematic offset, na naaayon sa likas na pagbabago-bago ng sa paglipas ng panahon.
-
Two-qubit errors: Ang mga sinukat na halaga ay patuloy na nasa itaas ng mga naiulat. Ito ay inaasahan dahil ang mga naiulat na halaga ay sinusukat sa nakahiwalay na gates, habang ang layer fidelity na eksperimento ay pinapatakbo ang maraming gates nang sabay-sabay kaya kasama na ang crosstalk. Mas relevant ang layered na mga numero para sa malalalim na circuit, ngunit hindi ito direktang maikukumpara sa naiulat na calibration data.
-
: Ang mga sinukat na halaga ay malinaw na nasa ibaba ng mga naiulat para sa karamihan ng qubit. Muli, malaki ang papel ng methodology, na susuriin sa susunod na seksyon.
Suriin ang mga indibidwal na resulta ng eksperimento
Maaari mo ring suriin ang raw na resulta ng mga indibidwal na characterization experiment sa pamamagitan ng experiment_data property, na nagbabalik ng mga underlying Qiskit Experiments ExperimentData objects. Halimbawa, ipinapakita ng sumusunod ang sinukat na decay curve ng isang qubit, na kapaki-pakinabang para tiyakin ang kalidad ng fit bago paniwalaan ang numerong nabuo nito.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Sukatin ang T2 gamit ang dynamical decoupling train
Bilang default, ang na eksperimento ay naglalapat ng iisang Hahn echo at sinusukat ang lahat ng qubit nang sabay-sabay, na, gaya ng ipinakita ng comparison plot sa itaas, ay maaaring magbunga ng kapansin-pansing mas mababang na halaga kaysa sa iniulat ng backend. Isang hypothesis ay ang bilang ng echoes: maaaring naka-calibrate ang mga naiulat na halaga gamit ang dynamical decoupling, na pumipigil sa low-frequency noise. Para masubukan ito, magpatakbo ng -only na characterization na may t2_num_echoes na naka-set sa mas malaking halaga, na naglalapat ng CPMG-style na train ng echo pulses. Kumakatawan ang mga delay sa kabuuang free-evolution time sa parehong kaso, kaya direktang maikukumpara ang mga fitted na halaga ng sa mga resulta ng single-echo.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
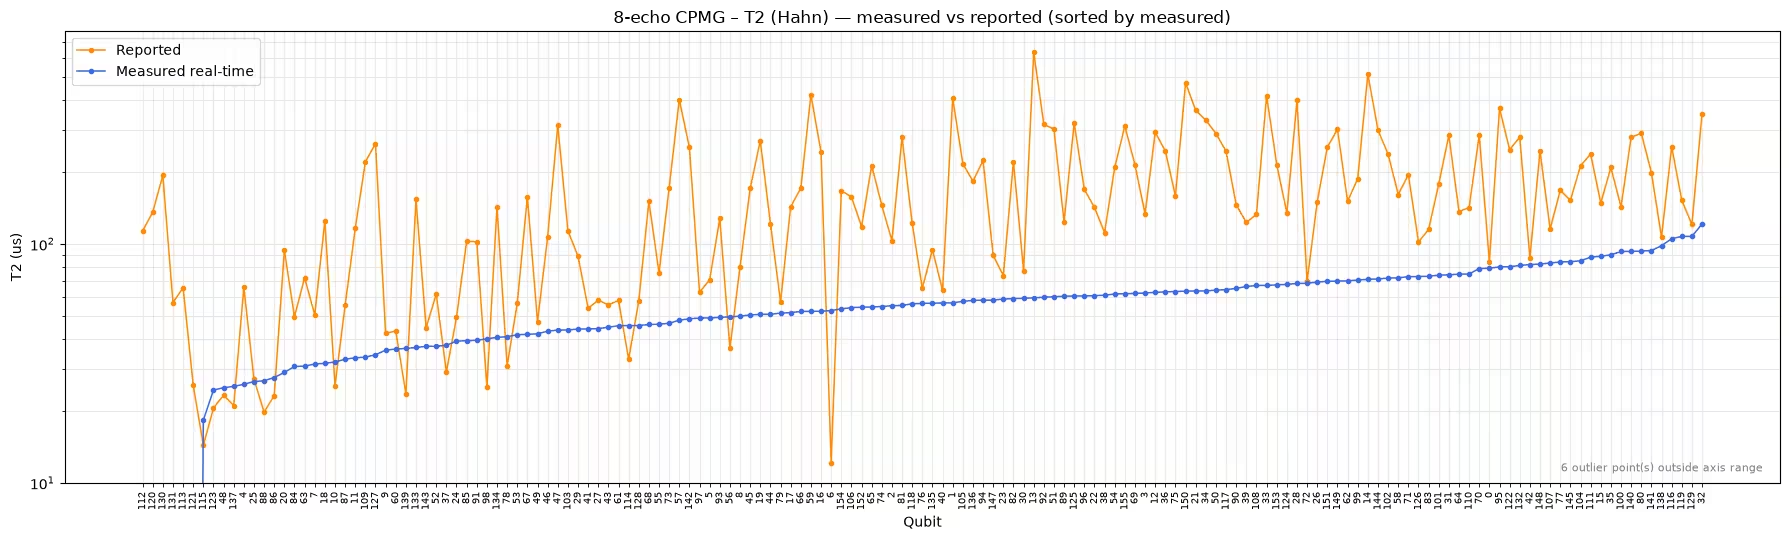
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
Sa run na ito, halos hindi nagbago ang resulta dahil sa dagdag na echoes: ang 8-echo median (56 µs) ay malapit sa single-echo (53 µs), at pareho pa ring lubhang mas mababa sa naiulat na median (142 µs). Ang bilang lang ng echoes ay hindi sapat para ipaliwanag ang gap na ito; may iba pang methodological na pagkakaiba na kasangkot, tulad ng mga detalye ng calibration procedure, pagsukat sa lahat ng qubit nang sabay-sabay sa halip na nakahiwalay, at iba pa.
Ang praktikal na aral ay ang pag-ingat sa paghahambing ng (at layered two-qubit error) sa iba't ibang methodology. Ang mga na-refresh na halaga ay isang self-consistent na snapshot na kinuha sa ilalim ng mga kondisyong malapit sa aktwal na workload, na ginagawa itong angkop para sa paghahambing ng mga qubit sa isa't isa o pagsubaybay sa device sa paglipas ng panahon. Ang isang gap kaugnay ng naiulat na calibration data, gayunpaman, ay hindi awtomatikong ebidensya ng drift.
Steps 1–4 na pinagsama-sama sa iisang tawag
Para sa pang-araw-araw na paggamit, bihira mong kailanganin ang mga intermediate na resulta. Pinagsasama-sama ng run_and_update method ang lahat ng ginawa mo sa itaas (paggawa, pagsusumite, pag-fit, at pag-update) sa iisang tawag na nagbabalik ng na-refresh na backend. Tinatanggap nito ang parehong experiments list (at ipinapasa ang mga opsyon tulad ng t2_num_echoes), at maaari rin itong i-wrap sa Batch o Session context.
Hindi magbabalik ang sumusunod na cell hanggang matapos ang lahat ng job at post-processing.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Handa na ngayong gamitin ang na-refresh na backend_updated object saanman kinakailangan ng backend properties sa iyong workflow. Subukan ang proseso na ito kasabay ng Real-time benchmarking for qubit selection na tutorial para piliin ang mga qubit na may pinakamahusay na performance kapag nag-transpile ng circuit. Dahil patuloy na nag-drift ang device, i-refresh ang mga property malapit sa oras na aktwal mong isasagawa ang iyong workload.
Mga susunod na hakbang
Kung interesado ka sa gawaing ito, maaaring maging interesado ka rin sa mga sumusunod na materyal:
- Gamitin ang na-refresh na mga property para pumili ng mas magagandang qubit sa Real-time benchmarking for qubit selection na tutorial
- Alamin kung paano inilalantad ang naiulat na calibration data sa QPU information na gabay
- Galugarin ang mga indibidwal na characterization experiment sa Qiskit Experiments documentation
- Mag-browse ng karagdagang device-level benchmarks sa Qiskit Device Benchmarking repository