Parity Twine Optimizer: Isang Qiskit Function ni ParityQC
Tingnan ang sanggunian sa API
Ang Qiskit Functions ay isang experimental feature na available lamang sa mga user ng IBM Quantum® Premium Plan, Flex Plan, at On-Prem (sa pamamagitan ng IBM Quantum Platform API) Plan. Nasa preview release status pa ito at maaaring magbago.
Pangkalahatang-ideya
Ipinapahintulot ng Parity Twine Optimizer sa mga user na lutasin ang mga optimization problem gamit ang quantum computers sa pamamagitan ng Parity Twine method. Ang approach na ito, na binuo sa ibabaw ng Parity Architecture, ay gumagamit ng ParityQC compiler para bawasan ang gate counts at circuit depth na kinakailangan para magpatakbo ng quantum algorithm habang isinasaalang-alang ang device connectivity.
Ang pagbawas na ito sa resource ay nagbibigay-daan sa paglutas ng mga optimization problem na mahalaga sa industriya para sa mga sukat na hindi kayang lutasin ng standard, SWAP-heavy, transpilation methods. Inaawtomatiko ng Parity Twine Optimizer ang mga transpilation step at maaaring gamitin kahit kaunti lang ang input ng user.
Nauunahan ng Parity Twine approach ang lahat ng ibang compilation method sa pagbawas ng gate counts at circuit depths para sa mga quantum algorithm tulad ng quantum approximate optimization algorithm (QAOA) at quantum Fourier transform (QFT). Sa pamamagitan ng pag-abstract ng quantum information palayo sa physical qubits, naipapatupad ang non-local interactions nang walang SWAP gates. Sa halip, ang Parity Twine chains (mga sequence ng CNOT gates) ay sistematikong namamahagi ng logical parity information sa pagitan ng mga qubit.
Ginagamit ng optimizer ang QAOA para bawasan ang energy ng ibinigay na cost function. Ang QAOA ay isang hybrid quantum-classical variational algorithm na dinisenyo para lutasin ang combinatorial optimization problem sa pamamagitan ng pagtantiya sa ground state ng cost Hamiltonian (). Ang mixing term () ay nagtutulak ng mga transition sa pagitan ng mga estado para tuklasin ang solution space. Ang alternating sequence ng mga terminong ito, na kinokontrol ng mga parameter na at , ay tumutukoy sa unitary , na kumikilos sa paunang estado.
Ang pag-encode ng problem unitary, exp(), ay nangangailangan ng pag-encode ng lahat ng logical -body rotation operators (exp()). Maaari itong maisagawa gamit ang -body generators (Parity Twine Networks), na binabawasan ang QAOA circuit depth at two-qubit gate count.
Deskripsyon
Binubuo ang input ng Parity Twine Optimizer ng optimization problem, ang napiling pangalan ng IBM Quantum hardware, at karagdagang optional arguments para i-tailor ang mga setting ng transpilation at hardware execution. Ina-route ng optimizer function ang problem definition papunta sa Parity Twine Compiler. Ipinapakita ng Figure 1 ang buod ng function workflow.
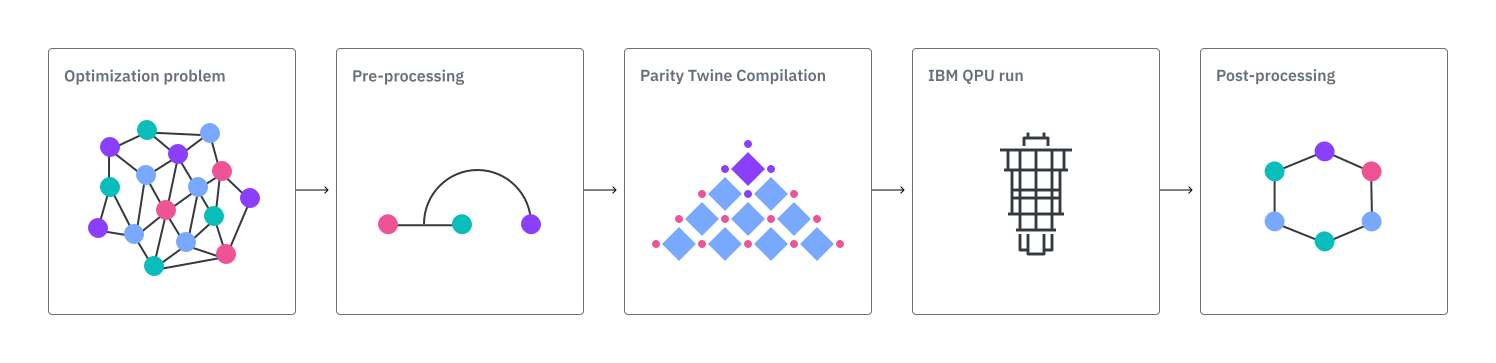
Ang input optimization problem ay pre-processed papunta sa isang (normalized) Hamiltonian. Pagkatapos ay bumubuo ang ParityQC compiler ng parameterized Parity Twine ansatz circuit, na tine-transpile papunta sa logical ansatz na tumutugma sa native gate set ng napiling hardware.
Ang QAOA circuit parameters ay classically optimized gamit ang "efficient depth one" approach at inilalapat sa transpiled circuit. Dahil isang round lang ng QAOA ang ginagamit, ang optimal na at parameters ay nakukuha gamit ang grid search sa CPU nang hindi na kailangan ng magastos na iterative optimization sa maraming circuit call. Malaki ang naitutulong nito sa pagbawas ng kinakailangang QPU runtime ng optimizer. Ang execution time kada circuit ay pangunahing tinutukoy ng constant overhead sa pagpapatakbo ng job sa QPU. Matapos itakda ang circuit parameters, isinusumite ang job sa itinalagang IBM® QPU.
Pagkatapos, dumadaan sa post-processing ang raw results. Ginagamit ng hakbang na ito ang local greedy search na umuulit nang random sa solution string at binabaligtad ang bit values kung ito ay nagpapababa sa value ng cost function.
Mga Benchmark
Maaaring depende ang performance sa parehong problem instance at sa mga susunod na processing step. Sa ilang kaso, ang classical samples at quantum-generated samples ay maaaring magkaroon ng magkatulad na final solution quality matapos ang equivalent post-processing. Kaya dapat isaalang-alang ng evaluation ang kabuuang optimization workflow.
Modelo ng Sherrington-Kirkpatrick
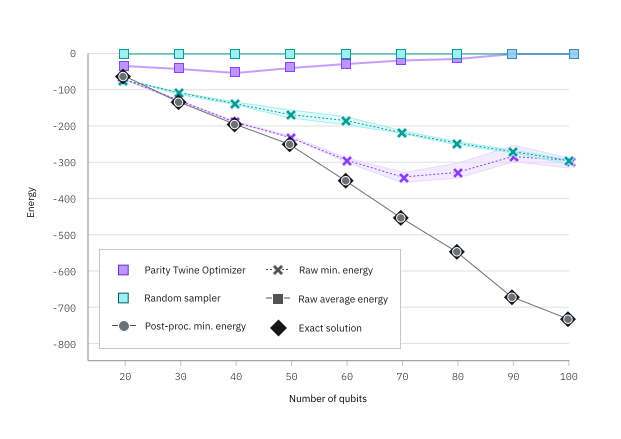
Ipinapakita ng Figure 2 ang pagiging epektibo ng Parity Twine Optimizer. Inihahambing nito ang mga resultang nakuha gamit ang optimizer laban sa random sampling para sa Sherrington-Kirkpatrick model sa pagdami ng mga qubit.
Ang post-processing ng parehong random at optimizer results ay humahantong sa eksaktong ground states, ngunit ang raw minimum energy output mula sa Twine QAOA ay palaging mas mahusay kaysa sa random na values. Para sa pinakamalaking bilang ng qubit na isinaalang-alang (90 at 100), pinapababa ng hardware noise ang kalidad ng resulta ng optimizer, kaya bumabalik ito sa raw values na katumbas ng random sampling.
Tingnan ang tutorial na ito para sa introduksyon sa Sherrington-Kirkpatrick model at mga detalye kung paano ito lutasin gamit ang Parity Twine Optimizer.
Market Split Problem
Ipinapakita ng Table 1 ang mga tiyak na performance metric para sa Parity Twine Optimizer na inilapat sa iba't ibang instance ng Market Split (MS) problem. Kinuha ang mga ito mula sa QOBLIB - Quantum Optimization Benchmarking Library at tumutugma sa mga submission na isinumite sa library gamit ang Parity Twine Optimizer.
Ang MS violation ay isang accuracy metric na sumusukat kung gaano kalayo ang solusyon sa pagtupad sa lahat ng constraint, na tinutukoy bilang . Ang mas mababang values ng metric na ito ay nagpapahiwatig ng mas tumpak na solusyon.
Inilathala ng Table 1 ang averaged values para sa limang run ng bawat instance gamit ang Parity Twine Optimizer na may ibm_boston device bilang backend at 100,000 shots.
Inilathala ang minimum MS violation na nakuha mula sa mga run ng bawat instance.
| Instance | Mga Qubit | Two-qubit gates | Two-qubit depth | MS violation | Oras ng mapping (s) | QPU runtime (s) | Oras ng post-processing (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Table 1: Performance metrics para sa iba't ibang instance ng market split problem. Ang mga pangalan ng instance ay para sa kaukulang halimbawa sa QOBLIB problem library. Tulad ng nabanggit na sa description section, ang QPU time ay minimal at halos constant, dahil isang round lang ng QAOA ang ginagamit na may optimal na circuit parameters na nakuha sa CPU.
Tingnan ang tutorial na ito para sa introduksyon sa Market Split problem at mga detalye kung paano ito lutasin gamit ang Parity Twine Optimizer.
Maximum Independent Set Problem
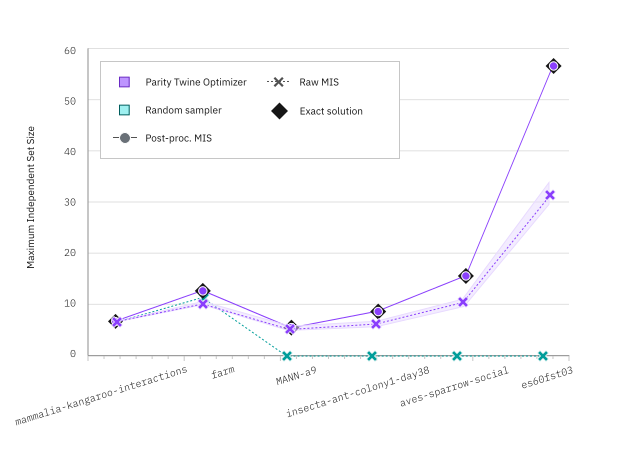
Inihahambing ng Figure 3 ang mga resultang nakuha gamit ang Parity Twine optimizer laban sa random sampling para sa maximum independent set problem para sa mga piniling instance na kinuha mula sa QOBLIB - Quantum Optimization Benchmarking Library. Ang mga ito ay saklaw mula 18 (mammalia-kangaroo-interactions) hanggang 114 (es60fst03) qubit.
Para sa maliliit na instance, magkatulad ang raw Maximum Independent Set size results mula sa optimizer at random sampling, ngunit para sa mas malalaking instance, mas mahusay nang malaki ang resulta ng optimizer. Ang post-processing ng parehong random-sampled at optimizer results ay muling humahantong sa mga set size na tugma sa eksaktong values.
Magsimula
Mag-authenticate gamit ang iyong IBM Quantum Platform API token at piliin ang Qiskit Function bilang:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Halimbawa
Maaaring ilapat ang Parity Twine Optimizer sa isang simpleng QUBO na halimbawa gaya ng sumusunod. Ang problema ay unang tinutukoy gamit ang dictionary:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Pagkatapos, dapat tukuyin ang variable type bilang binary o spin:
variable_type = "spin"
Tinutukoy nito ang objective function kung saan .
Pumili ng backend. Halimbawa:
backend_name = "ibm_phoenix"
Gamitin ang catalog.backends() para makita ang listahan ng mga available na backend mula sa user account/instance.
Kung walang tinukoy na backend, ang least-busy backend (ang isa na may pinakakaunting pending jobs) ang awtomatikong napipili.
Kapag na-load na ang optimizer (tingnan sa nakaraan), maaari mo itong patakbuhin sa problema gamit ang default options:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Suriin ang job status gaya ng sumusunod:
# Monitor the job status
function_job.status()
Kunin ang mga resulta gaya ng sumusunod:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Ang pag-print ng mga resulta ay nagbibigay ng sumusunod:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Ang solution dictionary ay tumutugma sa mga qubit na tinukoy sa problema (, at ) at ibinibigay ang kanilang optimized spin values.
Ang objective_value ay ang cost o energy ng optimization problem. Sinusukat nito ang kalidad ng solution.
Ang metadata ay nagbibigay ng impormasyon tungkol sa transpilation (two-qubit gate counts/depth, mga ginamit na gate, active qubits) at iba't ibang runtime para sa parehong quantum at classical compute time.
Bukod pa rito, nagbibigay ang metadata ng pasilip sa panloob na takbo ng algorithm. Makikita mo ang optimized variational parameters (beta at gamma) at masusuri kung paano bumuti ang distribution ng measured bitstrings matapos ilapat ang classical post-processing sa raw quantum results.
Lahat ng bitstrings sa result output ay maaaring i-map sa mga problem variable gamit ang variable_mapping.
Halimbawa, maaari mong i-map ang 'solution_bitstring': '100' gamit ang 'variable_mapping': {'0': 0, '1': 1, '2': 2} papunta sa binary solution: {'0': 1, '1': 0, '2': 0}.
Dahil nilulutas mo ang problema sa termino ng spin variables, kailangan mong ilapat ang binary to spin transformation (0 -> 1, 1 -> -1 ).
Sa huli, dadating ka sa final solution 'solution': {'0': -1, '1': 1, '2': 1}.
Tingnan ang sanggunian sa API para sa kumpletong detalye ng input at output ng Parity Twine Optimizer function.
Talaan ng mga Pagbabago
[1.0.2] - 2026-09-15
Notes
Minamarkahan ng release na ito ang unang stable production version ng Parity Twine Optimizer Qiskit Function. Inaasahang ipapakilala ng mga susunod na release ang sumusunod:
- higher-order problem compilation,
- karagdagang optimization algorithms, at
- mga pagpapabuti sa pre- at post-processing.
Mga Feature
- Lutasin ang sparse at dense QUBO problems gamit ang episyenteng Parity Twine Compiler.
Dokumentasyon
- Getting started user guide.
- Mga tutorial na may halimbawa para sa Market Split at Sherrington-Kirkpatrick problems.
- API documentation.
Kumuha ng suporta
Makipag-ugnayan sa ParityQC kung may mga tanong o isyu.
Mga Susunod na Hakbang
- Humiling ng access sa function sa pamamagitan ng pagkumpleto ng form na ito.
- Bisitahin ang API reference para sa Qiskit Function na ito.
- Subukan ang tutorial para sa paglalapat ng Parity Twine Optimizer sa Market Split problem.
- Subukan ang tutorial para sa paglalapat ng Parity Twine Optimizer sa Sherrington-Kirkpatrick model.
- Suriin ang Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025) ArXiv preprint.