Rimay Quantum Feature Extraction - isang Qiskit Function ng Kipu Quantum
Tingnan ang API reference.
Ang Qiskit Functions ay isang experimental na feature na available lang sa mga user ng IBM Quantum® Premium Plan, Flex Plan, at On-Prem (sa pamamagitan ng IBM Quantum Platform API) Plan. Nasa preview release status ito at puwedeng magbago.
Overview
Pinapalakas ng Rimay ang mga classical machine learning pipeline gamit ang mga feature na nabuo sa quantum hardware. Kumukuha ang function ng classical tabular data at nagbabalik ng set ng mga quantum-transformed na feature. Kapag pinoproseso ng isang quantum system ang data, nakakabuo ito ng mayayamang feature na kumukuha ng mga nonlinear na ugnayan sa pagitan ng mga input. Puwede mong gamitin ang mga nabuong feature nang mag-isa, o kasama ng orihinal mong mga feature, para mag-train ng anumang classical model. Sa maliliit at katamtamang laki ng dataset, puwedeng mapabuti ng mga quantum-transformed na feature ang kalidad ng prediction kumpara sa purong classical na baseline.
Ginawa ang function na ito para sa mga sumusunod na user:
-
Mga data science team na may umiiral na machine learning pipeline sa maliliit at katamtamang laki ng tabular dataset, kung saan huminto na ang pag-angat ng kalidad ng prediction. Idinaragdag mo ang Rimay bilang isang karagdagang preprocessing step, nang hindi ka gumagawa ng anumang quantum circuit.
-
Mga researcher na nag-eexplore ng mga quantum method para sa mga machine learning task.
Paglalarawan
Pinagsasama ng quantum feature extraction algorithm [1] ang dalawang prinsipyo ng quantum machine learning. Ang una ay ang quantum feature maps, na nag-e-embed ng data sa high-dimensional na Hilbert space kaya mas expressive ang mga representasyong nabubuo. Ang pangalawa ay ang quantum reservoir computing, na gumagamit ng dynamics ng isang quantum many-body system bilang nonlinear na transpormasyon ng input.
Ini-encode ng Rimay ang mga feature value at ang mutual information sa pagitan ng mga feature sa mga local field at coupling coefficient ng isang spin-glass Hamiltonian. Pinapaunlad ng counterdiabatic quantum dynamics ang system papunta sa mga low-energy state nito, na may mga nonlinear na halo ng mga correlation sa input data. Kinukuha ng Rimay ang mga correlation na ito sa pamamagitan ng pagsukat ng single- at two-body expectation value. Ang mga expectation value ang mga quantum-transformed feature na ipapasok mo sa iyong machine learning model.
Workflow
-
I-preprocess ang tabular data mo gaya ng gagawin mo sa classical machine learning. Kailangan ng Rimay ng mga numerical feature, kaya i-convert ang mga categorical feature sa numerical, halimbawa gamit ang
OneHotEncoderng scikit-learn. -
Hatiin ang data sa training set at test set, at i-upload ang dalawa sa function, tulad ng ipinapakita sa seksyong Halimbawa.
-
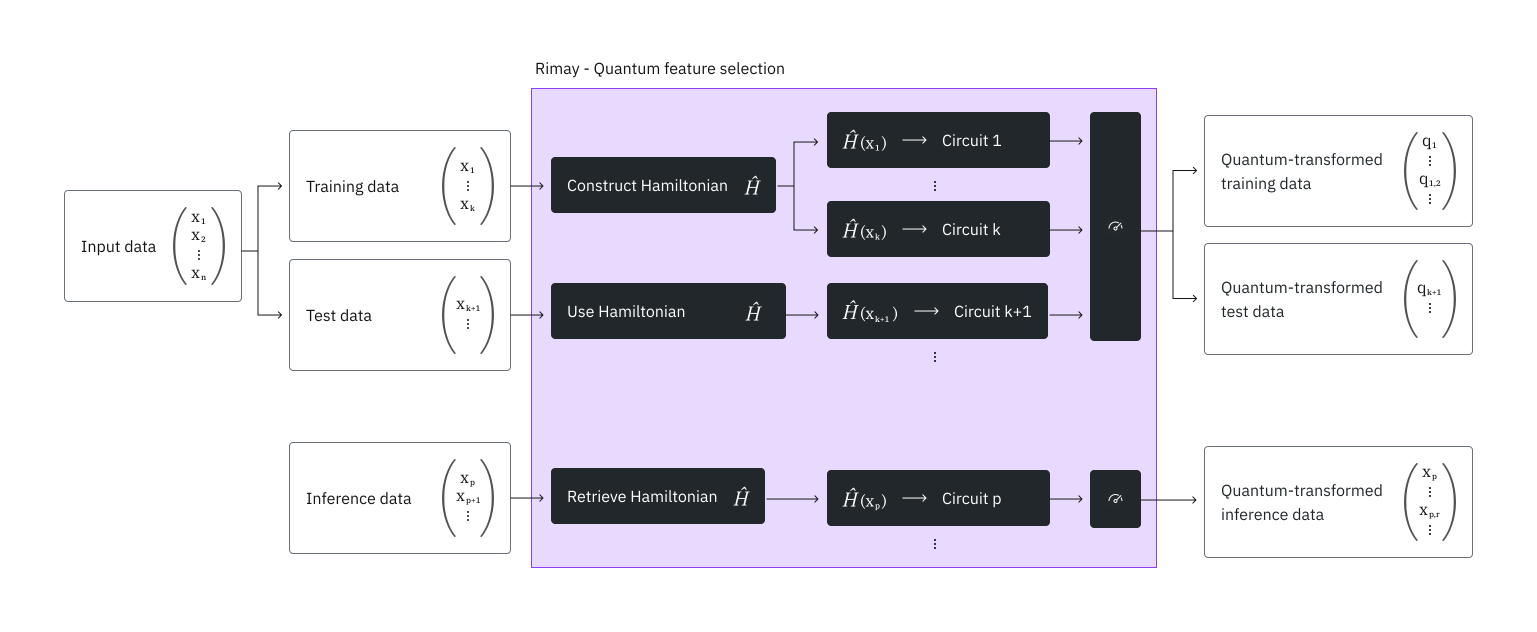
Ginagamit ng Rimay ang training data para buuin ang Hamiltonian na kumakatawan sa data. Bawat feature ay katumbas ng isang qubit, at ang buong training set ang nagpapasya kung aling mga feature, at kaya aling mga qubit, ang nag-iinteract. Sine-save ng Rimay ang istrukturang ito para ma-map nito ang test data at ang mga susunod na inference data gamit ang parehong Hamiltonian.
-
Para sa bawat sample, itinatakda ng mga feature value ang mga local field ng Hamiltonian, at itinatakda naman ng mutual information sa pagitan ng mga feature ang mga coupling coefficient ng istruktura mula sa hakbang 3. Dini-digitize ng Rimay ang counterdiabatic evolution ng Hamiltonian na ito para maging circuit, at pinapatakbo ang mga circuit sa QPU.
-
Sinusukat ng Rimay ang mga nagresultang bitstring, saka kinukuwenta ang mga single-body expectation value at ang mga two-body expectation value ng mga qubit na pisikal na magkakabit.
-
I-download mo ang mga expectation value sa anyong direkta mong maipapasok sa iyong model, o maihahalo sa orihinal mong mga feature.
Dahil sa istrukturang ito, ang bilang ng mga qubit na kailangan ng isang run ay katumbas ng bilang ng mga feature, at ang bilang ng mga circuit na isinusumite nito ay katumbas ng bilang ng mga sample.
Pagkatapos mong mag-fit ng mapping, maaari mong i-map ang bagong data gamit ito, halimbawa para sa inference. Kukunin ng Rimay ang Hamiltonian na ginawa nito habang nag-fit at bubuuin mula rito ang mga circuit para sa mga bagong sample.
Isama ang Rimay sa iyong machine learning pipeline
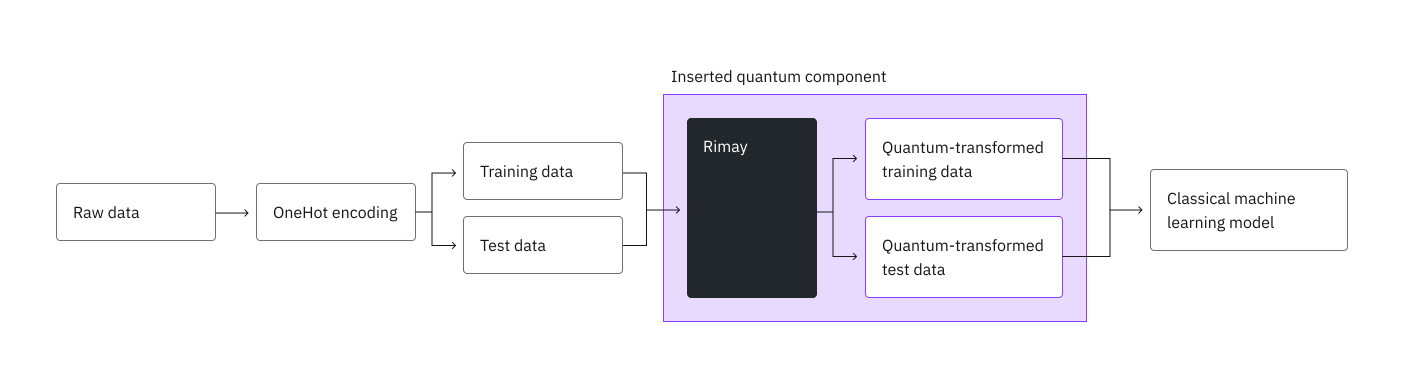
Tulad ng sa classical pipeline, magsisimula ka sa pag-preprocess ng raw data, halimbawa sa pamamagitan ng one-hot encoding ng mga categorical feature, at hahatiin ito sa training set at test set. Sa halip na direktang ipasok ang dalawang set sa iyong model, ipapasok mo muna sila sa Rimay, at ita-train mo ang iyong model sa mga quantum-transformed feature.
Mga benchmark
Ibinenchmark ng Kipu Quantum ang Rimay sa German credit dataset mula sa OpenML [2], na nag-uuri sa 1000 aplikante ng credit bilang mabuti o masamang credit risk. Mayroon itong 13 categorical at pitong numerical na attribute. Ang one-hot encoding ng mga categorical attribute ay nagreresulta sa 48 numerical feature. Itinatabi ng benchmark ang 20% ng mga sample bilang test set.
Bilang baseline, ilang classical model ang na-train sa mga classical feature. Gamit ang Rimay, na-train ang isang random forest sa dalawang paraan: sa mga quantum-transformed feature lang (Random forest Q), at sa mga quantum-transformed feature na sinamahan ng mga classical (Random forest H, para sa hybrid). Ang random forest lang ang nasa talahanayan, dahil ito ang pinakamahusay ang naging performance sa mga quantum-transformed feature.
| Model | Features | Accuracy | AUC | F1 score | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Classical | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Classical | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Classical | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Classical | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quantum | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Pinahusay ng mga hybrid feature ang lahat ng metric ng random forest maliban sa precision, at ang hybrid random forest ay umaabot sa mas mataas na AUC, F1 score, at recall kaysa sa CatBoost sa mga classical feature. Ang pinakamalaking epekto ay sa recall, na tumataas mula 0.921 hanggang 0.957. Ang mga quantum-transformed feature lang ay hindi umaabot sa precision ng mga classical model.
Ang test set ay may 200 sample lang, kaya kapag may isa pang sample na tamang nahulaan, gumagalaw ang accuracy ng 0.005. Basahin ang mga pagkakaiba bilang trend na kailangan pang i-verify, hindi bilang makabuluhang epekto. Maaari ring umasa ang accuracy ng prediksyon sa ingay mula sa hardware ng mga nakuhang feature. Kaya gumamit ng sapat na shots para hindi malimitahan ng shot noise ang resulta.
Ginamit ng benchmark ang mga sumusunod na resource:
| Example | Number of qubits | Number of samples | Number of shots | Total time (min) | QPU usage (min) | Processor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Ang bilang ng mga sample, na siyang bilang ng mga circuit, ang nagtatakda ng QPU time. Gamitin ang Nighthawk r2 na uri ng processor, dahil malaki ang nababawas nito sa kinakailangang QPU time.
Mga input
Ang mode ang nagtatakda kung aling mga parameter ang kailangan ng isang run. Para sa paglalarawan ng bawat input parameter, tingnan ang API reference.
Mga input file
-
I-upload ang bawat file gamit ang
catalog.file_upload()bago mo patakbuhin ang function. -
Pinapalitan ng isang upload ang anumang naunang file na may parehong pangalan, kahit para sa job na isinumite mo pero hindi pa nagsisimula. Para magpatakbo ng ilang job nang sabay-sabay, bigyan ng sariling pangalan ang mga file ng bawat job, halimbawa
run1_x_train.csvatrun2_x_train.csv. -
Ang bawat file ay CSV file na may header row. Ang bawat column ng feature file ay isang feature, at dapat numeric ang bawat value.
-
Ang
y_trainay may eksaktong isang numeric na column, na may isang label bawat row ngx_train. I-map ang mga categorical label sa mga numero, halimbawa good at bad sa 1 at 0. -
Dapat magkapareho ang mga column ng
x_testatx_inferenceat ngx_train, sa parehong ayos.
Ang mapping_id ang tanging paraan para maabot ang mapping na nabuo ng iyong fit, at hindi ito mahahanap o mababawi. Pinapahintulutan nito ang paggamit ng mapping na iyon, kaya ituring itong credential at huwag ibahagi. Kung mawala mo ito, kailangan mong mag-fit ng bagong mapping, na nangangailangan ng isa pang run sa quantum hardware. Itala rin ang backend_name ng fit, dahil sa processor na iyon lang tumatakbo ang mapping.
Mga limitasyon
-
Ang bawat feature ay imamapa sa isang qubit, kaya dapat may kahit kasing dami ng qubit ang processor kaysa sa bilang ng feature ng data mo. Kung mas marami ang feature mo, bawasan muna ang mga ito gamit ang feature selection technique.
-
Ang bawat sample ay nagiging isang circuit, at binibilang ng isang run ang training at test sample nang magkasama. Ang isang run ay maaaring maglaman ng hanggang 15,000 sample.
-
Ang isang job ay maaaring humiling ng hanggang 10 milyong execution, kaya ang bilang ng mga sample na minultiply sa
shotsay hindi dapat lumampas sa 10 milyon. -
Dapat matapos ang isang job sa loob ng 24 oras, kasama ang oras na naghihintay ang mga circuit nito sa queue ng processor. Ang job na mas matagal tumakbo ay ihihinto nang walang resulta. Sa busy na processor, panatilihing mas mababa nang malayo sa mga limitasyong ito ang malalaking dataset.
Mga output
Ang job.result() ay nagbabalik ng dictionary. Ang mga quantum-transformed feature mismo ay isinusulat sa mga CSV file na dina-download mo gamit ang catalog.file_download(). Para sa paglalarawan ng bawat key ng dictionary, tingnan ang API reference. Para sa oras na inabot ng bawat execution phase, tingnan ang Run metadata.
Ang bawat output file ay may isang row bawat input row, sa ayos ng input file, at isang column bawat quantum-transformed feature. Ang mga column na ang pangalan ay nagsisimula sa corr_ ay ang mga two-body expectation value. Walang label column ang mga file. Ang mga label ng training data mo ay nananatili sa iyong y_train file.
Run metadata
Ang resource_usage ay may isang entry para sa bawat execution phase na dinaanan ng run: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING", at, sa QPU, kadalasan "RUNNING: WAITING_FOR_QPU". Ang bawat entry ay may CPU_TIME, ang wall-clock time ng phase sa segundo, at QPU_TIME, ang QPU time sa segundo. Sa QPU, ang QPU time na siningil ng IBM ay nakatala sa ilalim ng "RUNNING: MAPPING", ang phase kung saan tumakbo ang mga circuit.
Ang "RUNNING: WAITING_FOR_QPU" ay ang oras na naghintay ang mga job mo sa IBM queue. Kinukuha ng run ang oras na ito mula sa mga timestamp ng IBM job, at hindi ito binibilang sa "RUNNING: MAPPING". Kung hindi iniuulat ng IBM ang mga timestamp na iyon para sa bawat job, wala ang entry, at bahagi ng "RUNNING: MAPPING" ang paghihintay.
Tinatapos ng IBM® ang pagkuwenta ng usage nito ilang sandali pagkatapos matapos ang job. Naghihintay ang run nang hanggang halos isang minuto para rito. Ang usage na kinukuwenta pa rin pagkalipas ng oras na iyon ay hindi kasama sa QPU_TIME, at makikita ang pinal na usage sa IBM Quantum Platform. Kung hindi mabasa ng run ang usage mula sa IBM, ang QPU_TIME ay None.
Halimbawa:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Magsimula
Mag-authenticate gamit ang iyong IBM Quantum Platform API key, at piliin ang Qiskit Function tulad ng sumusunod:
Ipinapalagay ng sumusunod na code na na-save mo na ang iyong mga credential. Kung hindi pa, sundin ang mga tagubilin sa Install the Qiskit Functions Catalog client para i-save ang account mo gamit ang iyong API key.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Mga laki ng function
Ang bawat job ay tumatakbo sa isang laki — S, M, o L. Kung masyadong maliit ang tinukoy na laki, tatanggihan ang job. Kung mas malaki ang laki kaysa sa kailangan, tatakbo ito sa mas malaking compute profile kaysa sa hinihingi ng gawain.
Ang laki ng isang Rimay job ay nakasalalay sa bilang ng mga sample na ima-map nito: ang mga row ng x_train at x_test para sa fit-transform, at ang mga row ng x_inference para sa transform. Hindi binibilang ang mga label sa y_train, at walang sample na ima-map ang isang delete run.
| Size | Samples per job | Compute profile | vCPU | RAM |
|---|---|---|---|---|
S | Up to 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 to 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 to 15,000 | 16x128 | 16 | 128 GB |
Ang bilang ng mga sample lang ang criterion. Walang binabago ang laki maliban sa compute profile: pareho para sa bawat laki ang mga limitasyon sa mga feature, sample, at shots. Ang S at M ay tumatakbo sa parehong compute profile at nagkakaiba sa bilang ng mga sample na sinasaklaw ng bawat isa.
Ang default ay M, na ginagamit kapag walang hiniling na laki ang job. Kaya ang job na may higit sa 9,999 sample ay dapat humiling ng L.
Maaari mo ring basahin ang mapping mula mismo sa function gamit ang rimay.sizes_map, at ang laki kung saan tumatakbo ang isang job kapag wala itong hiniling na laki gamit ang rimay.default_size.
Kuwentahin ang laki bago magsumite
Patakbuhin ito sa sarili mong mga input. Binabasa lang nito ang mga ito at wala nang iba: walang isinusumiteng job at walang nirereserba, kaya maaari mo itong tawagin nang kasing dalas ng gusto mo.
Ipasa ang mismong mga data set, hindi ang mga pangalan ng file, sa parehong ayos ng input_file, kasama ang mode ng run. Ipinapakita ng Hakbang 2 ng halimbawa ang pagtawag.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Kung masyadong maliit ang laki, babagsak ang job na may error na 4600 at ang mensahe ay nagsasaad ng laki na dapat gamitin sa halip. Kung mas malaki ito kaysa sa kailangan, normal na tatakbo ang job at magtatala ng 4601 advisory event.
Halimbawa
Ipinapakita ng halimbawang ito kung paano mag-upload ng data, patakbuhin ang function, at kunin ang mga quantum-transformed feature. Para sa end-to-end na halimbawa na kasama ang preprocessing at ang pagte-train ng classical model, tingnan ang tutorial.
1. I-upload ang data
Gumagamit ang halimbawang ito ng maliit na synthetic na dataset na may apat na numeric na feature at binary label, kaya apat na qubit lang ang kailangan ng run at mabilis itong natatapos. Isinusulat ito ng susunod na cell sa apat na CSV file: ang training feature, ang training label, ang test feature, at ang mga feature para sa hakbang 4 ng halimbawang ito. Para gamitin ang sarili mong data, isulat sa halip ang iyong mga preprocessed na training at test set sa mga file na may parehong layout.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
I-upload ang mga training at test file. I-a-upload mo ang x_inference.csv sa hakbang 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Patakbuhin ang function
Kuwentahin ang laki ng run mula sa data na in-upload mo, gamit ang calculator mula sa Mga laki ng function.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Pumili ng processor na may kahit kasing dami ng qubit ang bilang ng feature ng data mo, at patakbuhin ang function sa fit-transform mode gamit ang laking iyon. Apat ang feature ng sample data, kaya anumang IBM Quantum processor ay kayang magpatakbo nito.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Tingnan ang status ng workload o ibalik ang mga resulta tulad ng sumusunod:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Kunin ang mga resulta
I-download ang mga quantum-transformed feature. Ipasa ang target_name para ma-save ang bawat file sa sarili nitong pangalan.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. I-map ang bagong data
Pagkatapos mong i-train ang iyong model, i-map ang bagong data gamit ang na-fit na mapping, halimbawa para magpatakbo ng inference. Imamapa ng halimbawang ito ang x_inference.csv, na isinulat ng unang cell ng halimbawang ito. Ipasa ang mapping_id na ibinalik ng fit, para ang mga bagong row ay ma-map gamit ang parehong mapping sa halip na bago.
Ang mapping ay binubuo para sa qubit layout ng isang processor, kaya ipasa ang parehong backend_name ng fit, na ibinalik ng fit sa result["backend_name"]. Huwag gamitin ang least_busy() para piliin ang processor, dahil maaari itong magbalik ng ibang processor. Tinatanggihan ng Rimay ang anumang ibang processor bago ito magsumite ng anuman. Ang bilang ng shot ay galing din sa fit.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Burahin ang mapping
Kapag hindi mo na kailangan ang na-fit na mapping, burahin ito. Ang delete run ay walang ginagawang quantum na gawain, kaya hindi nito kailangan ng processor, shots, o laki ng function. Hindi mo maaaring bawiin ang pagbura. Pagkatapos ng pagbura, wala nang tinutukoy ang mapping_id, at babagsak ang isang transform run na gumagamit nito.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Kunin ang mga mensahe ng error
Kung ang status ng workload mo ay ERROR, gamitin ang job.error_message() para kunin ang mensahe ng error, tulad ng sumusunod:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Ang bawat error na iniuulat ng Rimay ay may kasamang code mula sa IBM Quantum error codes, isang mensahe, at isang solusyon na nagsasaad ng value na ipinasa mo at ng value na pinapayagan. Inililista ng sumusunod na talahanayan ang mga pinakakaraniwang error:
| Code | Cause |
|---|---|
1221 | A parameter is missing or has the wrong type, mode is not valid, a file named in input_file was not uploaded, the files do not match each other, a feature is not numeric, or the mapping_id does not match a stored mapping. |
1221 | A "transform" run names a different backend_name than the fit that produced its mapping. |
1216 | Your instance has no processor with the backend_name that you passed. The solution lists the processors it does have. |
1200 | Your API key does not have access to the instance that the job runs under. |
3200 | backend_name does not start with ibm_. |
4500 | The data has more features than the processor has qubits. |
6000 | The number of samples times shots exceeds 10 million executions. |
6001 | shots is smaller than 1. |
6002 | The data has more samples than a run allows. |
Mga use case
Sa tabular classification sa maliliit at katamtamang laking dataset, inilapat ng Kipu Quantum ang quantum feature extraction sa mga sumusunod:
Bukod sa tabular data, maaaring gawing numerical feature ng mga frozen neural network ang mga larawan, na imamapa naman ng quantum feature extraction bilang mga quantum-transformed feature:
Humingi ng suporta
Para sa suporta, makipag-ugnayan sa support@kipu-quantum.com.
Mga susunod na hakbang
-
Bisitahin ang API reference para sa Qiskit Function na ito.
-
Subukan ang tutorial na Classify credit risk with Kipu Quantum's Rimay quantum feature extraction.
-
Basahin ang Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
-
Basahin ang Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Mga sanggunian
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Karagdagang impormasyon
Ang Rimay ay salitang Quechua na nangangahulugang "magpaliwanag".