I-classify ang credit risk gamit ang Rimay Quantum Feature Extraction ng Kipu Quantum
Ang Qiskit Functions ay isang experimental na feature na available lang sa mga user ng IBM Quantum® Premium Plan, Flex Plan, at On-Prem (sa pamamagitan ng IBM Quantum Platform API) Plan. Nasa preview release status ang mga ito at maaaring magbago.
Tantiya ng paggamit: 2 minuto sa isang Nighthawk r2 processor. (TANDAAN: Tantiya lang ito. Maaaring mag-iba ang runtime mo.)
Mga layunin sa pagkatuto
-
Maghanda ng tabular data na may categorical at numerical na column para sa Rimay Qiskit Function.
-
Mag-fit ng quantum feature mapping sa training data at i-map ang test data sa parehong run.
-
Mag-train ng mga klasikal na model sa mga feature na binago ng quantum, mag-isa at kasama ng orihinal na mga feature.
-
Ihambing ang mga resulta sa purong klasikal na baseline.
Mga paunang kailangan
Bago mo simulan ang tutorial na ito, dapat pamilyar ka sa mga sumusunod na paksa:
-
Supervised classification gamit ang scikit-learn
Background
Maraming problema sa machine learning sa industriya ang may maliliit o katamtamang laki ng tabular dataset, kung saan hindi na puwedeng dagdagan ang data at humihinto na sa pag-angat ang accuracy ng model. Tipikal na halimbawa ang credit risk scoring. Gumagamit ang isang nagpapautang ng ilang dosenang attribute para magpasya kung malamang bang babayaran ng aplikante ang kredito.
Ang Rimay, isang Qiskit Function mula sa Kipu Quantum, ay nagdaragdag ng quantum preprocessing step sa ganitong pipeline. Ipinapatupad nito ang digitized counterdiabatic quantum feature extraction algorithm [1]. Ang bawat input feature ay minamapa sa isang qubit. Ang mga halaga ng feature at ang mutual information sa pagitan ng mga feature ang nagtatakda ng mga local field at coupling ng isang spin-glass Hamiltonian. Pagkatapos, pinapaunlad ng counterdiabatic dynamics ang quantum system papunta sa mga low-energy state nito, at ang mga single- at two-body expectation value na nasusukat sa dulo ang nagiging bago at quantum-transformed na mga feature. Nakukuha ng mga feature na ito ang mga nonlinear na ugnayan sa pagitan ng mga input, at puwede mo silang ipasok sa kahit anong classical model.
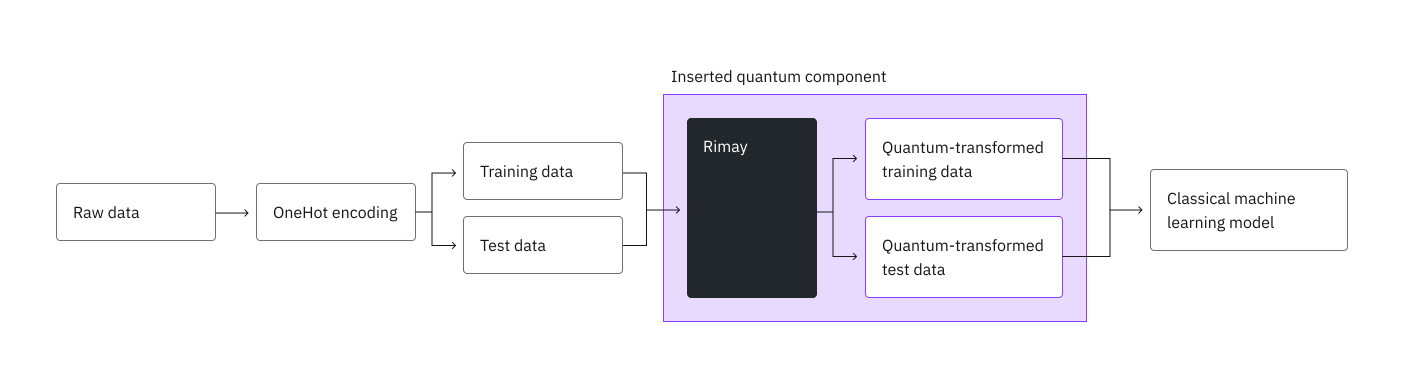
Gumagamit ang tutorial na ito ng German credit dataset mula sa OpenML [2], na may 1000 aplikante at 20 attribute, para mag-train ng random forest classifier. Una, gagawa ka ng classical baseline, pagkatapos ay ipapadala ang data sa Rimay, at panghuli ay ite-train ang parehong uri ng model sa mga quantum-transformed na feature, nang mag-isa at kasama ng orihinal na mga feature.
Requirements
Bago mo simulan ang tutorial na ito, siguraduhing naka-install ang mga sumusunod na package:
-
IBM Quantum Compute client (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Kailangan mo rin ng access sa Rimay function mula sa Qiskit Functions Catalog.
Setup
I-import ang mga package at magdefine ng dalawang helper: isang nagte-train ng random forest, at isang kumukuwenta ng mga metric na ginagamit sa buong tutorial.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
I-configure ang IBM Quantum credentials
Mag-authenticate gamit ang iyong IBM Quantum Platform API key, i-load ang Rimay function, at piliin ang quantum processor na pinakamaluwag ang pila na available sa instance mo.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Step 1: I-map ang mga classical input sa isang quantum problem
Minamapa ng Rimay ang bawat numerical input feature sa isang qubit, kaya ang unang hakbang ay gawing numerical na mga feature ang raw na table.
I-load ang dataset
I-load ang German credit dataset direkta mula sa OpenML. Ang column na class ang may hawak ng label: good para sa mga aplikanteng nakabayad ng kredito at bad para sa mga hindi.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
I-encode ang mga feature
I-convert ang label sa binary na halaga, at i-one-hot encode ang 13 categorical na column. Tinatanggal ng code ang unang category ng bawat column para iwasan ang redundant na mga feature, kaya 48 numerical na feature ang lalabas.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Hatiin sa training at test set
Itabi ang 20% ng mga aplikante bilang test set. Pinapanatili ng stratified split na pantay ang proporsyon ng good at bad na kredito sa dalawang set.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Gumawa ng classical baseline
Mag-train ng random forest sa mga classical na feature. Sa Step 4, ikukumpara mo ang mga quantum-transformed na feature sa mga metric nito.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
I-upload ang data sa Rimay
Binabasa ng Rimay ang mga input nito mula sa mga CSV file na ina-upload mo sa function. Magkahiwalay na file ang mga feature at ang mga label. Ina-upload mo rin ang test set, para imapa ito ng Rimay gamit ang parehong mapping na na-fit sa training set.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Step 2: I-optimize ang problema para sa pag-execute sa quantum hardware
Binubuo at tina-transpile ng Rimay ang mga circuit para sa processor na pipiliin mo, kaya walang circuit na kailangang i-optimize nang mano-mano. Tukuyin ang bilang ng shot kada circuit, sa loob ng mga sumusunod na limitasyon:
-
Kailangan ng bawat feature ng isang qubit, kaya dapat kasing dami man lang ng mga feature ng dataset ang qubit ng processor.
-
Nagpapatakbo ang Rimay ng isang circuit kada row, training at test row nang magkasama. Isang job ay puwedeng humiling ng hanggang 10 milyong execution lang, kaya dapat manatili sa budget na iyon ang bilang ng row na i-multiply sa
shots.
Tingnan ang dalawang limitasyon bago mo i-submit ang job.
Dapat ding matapos ang isang job sa loob ng 24 oras, kasama ang oras na naghihintay ang mga circuit nito sa pila, kung hindi ay ihihinto ito nang walang resulta.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Kuwentahin ang function size
Tumatakbo ang bawat job sa isang function size, S, M, o L, na pumipili ng compute resources na gagamitin nito. Para sa Rimay, nakadepende ang size sa bilang ng row na minamapa ng isang job, training at test row nang magkasama. Kung humiling ka ng size na masyadong maliit, magfa-fail ang job na may error na 4600. Para sa mga size at limitasyon nila, tingnan ang Function sizes sa Rimay guide.
Dinedefine ng sumusunod na cell ang size calculator. Tumatakbo ito sa makina mo, binabasa lang ang data na ipinasa mo rito, at walang sinusubmit.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Ipasa ang mga data set sa parehong ayos ng mga file sa input_file, kasama ang mode ng run:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Step 3: I-execute gamit ang Qiskit primitives
Patakbuhin ang Rimay sa fit-transform mode. Magfi-fit ito ng quantum feature mapping sa x_train.csv at y_train.csv, at imamapa nito ang training at test set gamit iyon. Mahalaga ang ayos ng mga file sa input_file. Ilista ang training features, ang training labels, at pagkatapos ang opsyonal na test features. Ipasa ang size na kinuwenta mo bilang function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
I-monitor ang job
Tingnan ang status ng job habang tumatakbo ito. Hihinto ang job.result() hanggang matapos ang job.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
May mapping_id ang result, na tumutukoy sa mapping na na-fit ng run na ito. Hindi mo ito kailangan sa tutorial na ito, dahil namapa ang test set sa parehong run. I-record ang ID na ito kung gusto mong magmapa ng mga bagong row sa susunod gamit ang mode="transform". Ito lang ang paraan para ma-access ang na-fit na mapping, at kung wala ito, kailangan mong mag-fit at magbayad ng bago. Binuo ang mapping para sa qubit layout ng processor na ito, kaya dapat ipasa ng susunod na transform run ang parehong backend_name.
mapping_id = result["mapping_id"]
Step 4: I-post-process at ibalik ang result sa nais na classical na format
I-download ang mga quantum-transformed na feature
I-download ang mga file na isinulat ng job, gamit ang mga pangalan sa output_files. Nagsisimula ang bawat pangalan sa job ID, kaya mananatiling available ang mga file ng run na ito pagkatapos ng mga susunod na run. Ipasa ang target_name para mase-save ang bawat file sa sarili nitong pangalan.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Mag-train sa mga quantum-transformed na feature
Mag-train ng random forest sa mga quantum-transformed na feature lang.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Mag-train sa pinagsamang classical at quantum na feature
Pagsamahin ang orihinal at ang mga quantum-transformed na feature, at i-train ang parehong model sa kombinasyon.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Ihambing ang mga resulta
Ihambing ang tatlong model sa test set.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

Sinusukat ng AUC kung gaano kahusay ranggo ng isang model ang good sa ibabaw ng bad na kredito, na hindi nakadepende sa decision threshold, kaya ito ang pinakamakabuluhang metric sa imbalanced na dataset na ito (70% good na kredito). Sa mga benchmark ng Kipu Quantum, ang mga quantum-transformed na feature nang mag-isa ay umabot sa AUC na kahawig ng classical baseline, at ang hybrid model, na pinagsasama ang dalawa, ang umabot sa pinakamataas na AUC at F1 score. Kaya nagdaragdag ang mga quantum-transformed na feature ng impormasyong hindi naibibigay ng mga classical na feature nang mag-isa.
Maglinis (opsyonal)
Mananatiling available ang isang na-fit na mapping hanggang burahin mo ito. Kung ayaw mo nang magmapa ng iba pang data gamit nito, burahin ito. Walang quantum work ang pagbura, hindi ito gumagamit ng QPU time, at hindi na ito mababawi.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Konklusyon
Ano ang natapos mo
Sa tutorial na ito, natapos mo ang mga sumusunod:
-
Naghanda ng real-world na credit risk dataset na may categorical at numerical na attribute para sa quantum feature extraction.
-
Gumawa ng classical random forest baseline.
-
Ginamit ang Rimay para mag-fit ng quantum feature mapping sa quantum hardware at imapa ang training at test set sa isang run.
-
Na-train ang parehong model sa mga quantum-transformed na feature at sa pinagsamang mga feature, at inihambing ang mga ito sa baseline.
Mga pangunahing aral
-
Bumabagay ang Rimay sa umiiral na machine learning pipeline bilang isang karagdagang preprocessing step. Nananatili ang data preparation at ang classical model mo.
-
Ang bilang ng qubit ang naglilimita sa bilang ng input feature, at ang bilang ng row na i-multiply sa
shotsang naglilimita sa laki ng isang job. -
Gamitin bilang default ang mga quantum-transformed na feature na isinama sa orihinal na mga feature, dahil magagamit ng model ang pareho.
Mga susunod na hakbang
- Basahin ang Rimay guide para malaman ang lahat ng input, magmapa ng bagong data gamit ang
mode="transform", at makita ang iba pang benchmark. - Basahin kung paano inilapat ang quantum feature extraction sa satellite image classification [3].
Mga sanggunian
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.