Matuto ng mga maingay na quantum state gamit ang classical shadows
Tantiya ng paggamit: 34 minuto sa isang Heron r2 processor (PAALALA: Tantiya lamang ito. Maaaring iba ang runtime mo.)
Mga learning outcome
-
Mangolekta ng mga randomized measurement sa isang IBM® quantum processor mula sa Julia at i-save ang mga ito para sa susunod na pagsusuri
-
Suriin ang measurement data para sa mga sirang qubit at gate bago ang pagkatuto
-
I-fit ang isang matrix product operator (MPO) model ng maingay na state sa classical shadows
-
I-validate ang model sa mga held-out na measurement at ihambing ito sa ideal na circuit
Mga prerequisite
-
Classical shadows, gaya ng ipinakilala sa tutorial na Shadow tomography ng Greenberger-Horne-Zeilinger (GHZ) state
-
Density matrices at mixed states, na tinalakay sa Mga batayan ng quantum information
-
Pagpapatakbo ng mga circuit mula sa Julia gamit ang
Qiskit.jlatQiskitIBMRuntime.jl, gaya ng ipinakilala sa tutorial na I-simulate ang time evolution ng transverse-field Ising model
Pinagmulan at konteksto
Sa isang totoong quantum processor, ginagawa ng ingay na mixed state na ang pure state na na dinisenyong ihanda ng isang circuit. Kayang buuin muli ng buong quantum state tomography ang , pero lumalaki nang exponential ang bilang ng mga measurement na kailangan nito kasabay ng bilang ng mga qubit. Sa halip, natutunan nina Votto et al. [1] ang isang compact na model ng hanggang 96 qubit mula sa mga randomized measurement. Sinusunod ng tutorial na ito ang workflow nila.
Sa isang randomized measurement [2], bawat qubit na ay iniikot ng isang independiyenteng random na unitary na at saka sinusukat sa computational basis. Tinatawag na measurement setting ang isang draw ng mga pag-ikot, at inuulit ang bawat setting para sa shot. Ang isang shot na may outcome bit na ay nagbibigay ng classical shadow [3]
na ang average nito sa mga setting at shot ay . Kinukuha ng prerequisite na tutorial ang bawat mula sa tatlong Pauli basis; ang tutorial na ito, tulad ng paper, ay kinukuha ang mga ito nang uniform mula sa lahat ng single-qubit unitary (Haar random), at pareho pa rin ang formula.
Tinatantya ng mga shadow ang mga katangian ng ilang qubit sa isang pagkakataon. Pinagsasama ng paper ang mga ito sa isang matrix product operator (MPO), na isinusulat ang density matrix bilang isang kadena ng maliliit na tensor, isa bawat qubit; ang mga maingay na state na may short-range na correlation ay nangangailangan lang ng maliliit na bond sa pagitan ng magkakalapit na tensor. Tulad ng density matrix renormalization group (DMRG) algorithm, nag-i-sweep ang learner sa kadena at nag-a-update ng isang tensor sa bawat pagkakataon, kaya tumutugma ang model sa mga shadow sa window na qubit na nakasentro sa tensor na iyon (Equation 4 ng paper). Nananatiling fixed ang bond dimension habang ginagawa ang mga update na ito, kaya hindi kailanman nagta-truncate ng model ang learner. Dahil sa mga window na ito lang pumapasok ang data, hindi lumalaki ang bilang ng mga setting na kailangan kasabay ng haba ng kadena.
Hinahati ang mga setting sa isang training set at isang testing set. Sa testing set, tinatantya ng paper ang max fidelity sa pagitan ng at ng model na ,
Ang direktang pagsukat sa ay mangangailangan ng exponential na dami ng measurement. Sa halip, ina-assume ng paper ang approximate factorization condition (AFC): bumababa ang mga correlation sa sa loob ng ilang qubit, kaya ang mga global na overlap at purity ay nagfa-factor sa mga term sa mga block ng magkakalapit na qubit. Ibinibigay rin ng purity ang Rényi-2 entropy na , na sumusukat kung gaano kahalo ang state.
Inihahanda ng paper ang depth- na kicked-Ising state
sa 96 qubit ng ibm_brisbane, isang Eagle processor, na may 2,048 setting ng 1,024 shot para sa . Dalawang resulta para sa ang iniuulat ng Figure 1(c,d) ng paper:
-
Naaabot ng natutunang model ang kasama ang experimental na state sa , na higit na mataas kaysa sa overlap ng ideal na state na at ng eksperimento.
-
Linear ang paglaki ng entropy, , at tumutugma ang entropy ng model sa independiyenteng tantiya mula sa testing set.
Sinusuri ng tutorial na ito ang parehong resulta, una sa isang eight-qubit na simulation kung saan alam ang mga eksaktong sagot, at saka sa isang bagong 96-qubit na run sa ibm_fez, isang Heron r2 processor. Ang learner ay isang independiyenteng Julia implementation ng mga equation sa paper at supplement nito.
Mga kinakailangan
Nangangailangan ang tutorial na ito ng macOS o Linux, dahil hindi pa sinusuportahan ng Qiskit.jl ang Windows (Qiskit.jl issue #15). Kailangan mo rin ang mga sumusunod:
-
Julia 1.11, mula sa pahina ng pag-download ng Julia o gamit ang
juliaup add 1.11, at ang package naIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Para sa hardware na halimbawa, isang IBM Quantum® Platform account na may access sa isang QPU na may hindi bababa sa 96 qubit, at mga naka-save na credential. Kung wala kang account, maaari mong patakbuhin ang hardware na halimbawa mula sa mga naka-save na measurement ng
ibm_fezrun na gumawa ng mga resulta sa tutorial na ito. Tumatakbo nang walang account ang iba pang seksyon.
Gumagamit ang notebook ng Qiskit.jl at QiskitIBMRuntime.jl para bumuo at magpatakbo ng mga circuit, RandomMeas.jl [4] para sa mga randomized measurement (nagbibigay din ito ng ITensors.jl at ITensorMPS.jl), at NPZ.jl, JSON.jl, at Plots.jl. Nasubukan ang tutorial na ito gamit ang Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2, at RandomMeas.jl 0.3.1.
May dalawang paraan para i-set up ang environment:
-
Opsyon 1: I-install ang pinakabagong compatible na bersyon ng mga package sa isang pansamantalang environment. Patakbuhin ang sumusunod na cell nang walang pagbabago.
-
Opsyon 2: Eksaktong gayahin ang nasubukang environment. Itakda ang
download_toml_files = truesa sumusunod na cell. Dina-download ng cell angProject.tomlatManifest.tomlmula sa repository ng dokumentasyon papunta sa isang folder naenv_tutorial/classical-shadows/sa tabi ng notebook na ito, at saka ini-install ang eksaktong bersyon ng bawat package na nakatala sa manifest, kasama ang mga indirect na dependency. Para sa mga detalye, tingnan ang dokumentasyon ng Julia tungkol sa mga file na ito.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Pag-set up
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Ang helper module na mpo_learning.jl, na dina-download ng Setup cell, ang nag-iimplement ng learner. Tinatawag ng tutorial ang mga sumusunod na function mula rito:
| Function | Layunin |
|---|---|
kicked_ising_reference(N, D; depolarization) | Eksaktong MPO ng ideal na kicked-Ising state, o ng state pagkatapos ng local depolarizing noise |
split_settings(group; seed, train_fraction) | Random na i-assign ang mga measurement setting sa mga training at testing set (kalahati bawat isa bilang default) |
training_marginals(train; ell, prior) | Mga shadow estimate ng bawat learning window, mula sa mga training setting lang |
fitted_prior(ideal, train) | Prior para sa common randomized measurements (CRM), na naka-fit sa nasukat na purity ng bawat window, gaya ng sa paper |
learn_mpo(marginals, N; ell, maxbond, sweeps) | I-sweep ang one-site update ng paper sa kahabaan ng kadena, simula sa maximally mixed state |
max_fidelity(a, b), mpo_overlap(a, b) | Eksaktong at sa pagitan ng dalawang MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Mga AFC estimate ng at mula sa mga testing setting, na may jackknife na error bar |
Iniimbak ng learner ang MPO sa Pauli basis. Pinananatili nitong Hermitian na may unit trace ang model, pero hindi nito pinipilit na positive semidefinite ang model, kaya iniuulat ng notebook kung gaano ka-negatibo ang mga eigenvalue nito.
Maliit na halimbawa sa simulator
Magsimula sa isang system na sapat na maliit para makalkula ang lahat nang eksakto: ang depth-one na kicked-Ising state sa walong qubit, na may 12% local depolarizing noise para i-model ang hardware. Dahil alam ang maingay na state, maaari mong direktang ihambing ang natutunang model dito.
Hakbang 1: I-map ang mga classical na input sa isang quantum na problema
Ibinabalik ng function na kicked_ising_reference ang eksaktong state bilang MPO. Sa depolarization=0.12, lumiliit ng 12% ang Bloch vector ng bawat qubit pagkatapos ng circuit.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Hakbang 2: I-optimize ang problema para sa pagpapatakbo sa quantum hardware
Nagsa-sample ang halimbawang ito ng mga measurement outcome nang classical, kaya walang circuit na ita-transpile. Sinasaklaw ng hardware na halimbawa ang hakbang na ito.
Hakbang 3: Patakbuhin gamit ang mga Qiskit primitive
Gamitin ang RandomMeas.jl para mag-draw ng 2,048 Haar-random na measurement setting at mag-sample ng 256 shot mula sa bawat isa, at saka hatiin nang pantay ang mga setting sa mga training at testing set. Hatiin ayon sa setting at hindi ayon sa shot: ang mga shot mula sa parehong setting ay may parehong mga pag-ikot, kaya hindi sila independiyente.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Hakbang 4: I-post-process at ibalik ang resulta sa nais na classical na format
Alamin ang model gamit ang mga depth-one na parameter ng paper: mga window na umaabot ng qubit sa bawat gilid ng ina-update na tensor, bond dimension na 4, at 20 sweep na nagsisimula sa maximally mixed state. Ina-update ng unang sweep ang magkakalapit na pares ng tensor, na nagpapalaki sa bond dimension mula 1 hanggang 4; bawat sumunod na sweep ay nag-a-update ng isang tensor sa bawat pagkakataon sa fixed na bond dimension na iyon.
Para bawasan ang statistical noise ng mga shadow, gumagamit ang paper ng common randomized measurements (CRM) [5]. Para sa bawat setting, ibinabawas nito ang average na shadow na bubuuin ng isang prior na hula sa state sa parehong setting, at saka ibinabalik ang eksaktong halaga ng prior. Nag-a-average sa zero ang correction, kaya binabago ng prior ang laki ng statistical error pero hindi ang tinatantya. Dito, ang prior ay ang ideal na state na may 10% local depolarization, malapit sa totoong 12%. Sa hardware, hindi alam ang antas ng ingay, kaya sa hardware na halimbawa ay ifi-fit ang prior sa mga nasukat na purity, gaya ng ginagawa ng paper.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
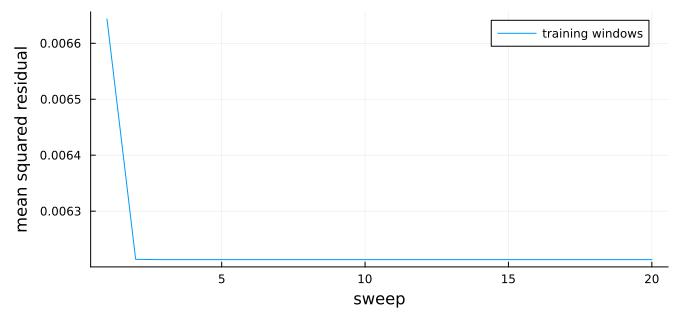
Sinusukat ng residual kung gaano kalayo ang mga window ng model sa mga training shadow. Bumababa ito kapag nagsimula ang mga one-site update, sa ikalawang sweep, at pagkatapos ay nananatiling halos pare-pareho sa halip na umabot sa zero, dahil may statistical noise ang mga shadow na hindi kayang gayahin ng model na may maliit na bond dimension.
Dahil alam ang state na ito, maaari mong ihambing nang eksakto ang natutunang model dito, at ihambing din dito ang dalawang pinakasimpleng hula: ang CRM prior at ang ideal na state.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Mas malapit ang natutunang model sa maingay na state kaysa sa prior o sa ideal na state, kaya natutunan nito ang ingay mula sa data. Ang maliliit nitong negatibong eigenvalue ay nagmumula sa limitadong bilang ng mga measurement.
Sa hardware, hindi alam ang state, kaya tinatantya mo na lang ang mula sa mga testing setting. Hinahati ng AFC ang kadena sa mga block na ng qubit at tinatantya ang purity sa pamamagitan ng
at ang sa pamamagitan ng parehong ratio ng mga local overlap. Sa , sinasaklaw ng dalawang block ang lahat ng walong qubit at eksakto ang formula; sa , umaasa ito sa factorization assumption. Sinasaklaw lang ng mga jackknife error bar, na nag-iiwan ng isang testing setting sa bawat pagkakataon, ang statistical error ng testing data, hindi ang randomness ng training o ang AFC approximation.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Parehong tumutugma sa eksaktong halaga ang dalawang held-out na estimate sa loob ng kanilang mga error bar.
Malakihang halimbawa sa hardware
Ngayon, patakbuhin ang eksperimento sa isang 96-qubit na kadena ng ibm_fez, isang Heron r2 processor. Tulad ng ibm_brisbane, may heavy-hex na coupling map ito at katulad na antas ng ingay.
Ang pagkolekta ng data ay nangangailangan ng 1,024 Sampler job at humigit-kumulang 34 minuto ng oras sa QPU. Kung wala kang access sa QPU na may hindi bababa sa 96 qubit, o mahaba ang queue, patakbuhin ang hardware example gamit ang mga sukat na naitala sa ibm_fez noong 27 Setyembre 2026, na siyang nagbigay ng mga resultang ipinapakita sa tutorial na ito. Kapag use_saved_data = true, dina-download ng notebook ang mga sukat na ito (15 MB) mula sa Zenodo [6] sa Step 1 at nilalaktawan ang pag-submit ng job sa Step 3. Para kolektahin ang sarili mong data, itakda ito sa false.
use_saved_data = true; # set to false to collect new measurements on hardware
Step 1: I-map ang mga classical na input sa isang quantum na problema
Bawat setting ay nangangailangan ng isang circuit: ang kicked-Ising circuit, isang gate sa bawat qubit para sa , at isang pagsukat ng bawat qubit. Ang pag-sample ng , kung saan ang , , at ay uniform sa , ay ginagawang Haar random ang . Ibinabalik ng function na u3_matrix ang matrix ng , na ginagamit ng Step 4.
Ang budget ay 1,024 na setting na may tig-1,024 shots, kalahati ng bilang ng mga setting sa paper, na hinati nang pantay sa training at testing. Kapag may saved data, nilo-load ng cell ang mga naitalang anggulo. Kung hindi, gumagawa ito ng mga bagong anggulo at sine-save ang mga ito bago ka mag-submit ng anuman, dahil hindi mo maa-analyze ang mga resulta kung wala ang mga ito. Kung umiiral na ang file, nilo-load ito ng cell, para magtugma pa rin ang mga anggulo sa mga naka-save na resulta pagkatapos mong i-restart ang session.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Step 2: I-optimize ang problema para sa pag-execute sa quantum hardware
Ang isang chain ay kasing-husay lang ng pinakamasamang qubit nito, kaya ikaw mismo ang pumili ng 96 na pisikal na qubit. Hindi pa tumatanggap ng fixed initial layout ang function na transpile ng Qiskit.jl, at sa isang test sa ibm_phoenix, may kasamang qubit na may 51% readout error ang layout na pinili nito. Ang sumusunod na chain ay ang 96-qubit na path sa coupling map ng ibm_fez na pinili ng error-aware na layout ng function na transpile ng Python Qiskit (na may optimization_level=3) mula sa calibration data noong 27 Setyembre 2026. Ang mean na readout error nito ay 1.6%, ngunit kakaunti ang 96-qubit na path sa isang heavy-hex lattice, at kasama sa isang ito ang qubit 35, na may 15% na readout error. Nagbabago ang mga calibration, kaya pumili ng bagong chain mula sa kasalukuyang calibration data bago ka mag-run sa ibang araw o ibang QPU.
Para mapanatili ang chain na ito, isulat nang direkta ang mga circuit gamit ang mga native gate sa halip na i-transpile ang mga ito. Ang isang gate ay katumbas ng hanggang sa isang global phase. Sinasaklaw ng decomposition na ito ang parehong random rotation at ang kick na . Ang gate na ay katumbas ng isang CZ gate na sinusundan ng sa dalawang qubit, hanggang sa isang global phase. Dahil diagonal ang mga gate na ito, nagko-commute sila sa mga CZ gate, kaya bawat qubit ay nakakaipon ng isang kada bond bago ang measurement rotation nito.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Step 3: I-execute gamit ang mga Qiskit primitive
Ang QiskitIBMRuntime.jl ay nagpapatakbo ng isang circuit kada Sampler job, kaya ang pagkolekta ng data ay nangangailangan ng 1,024 na job. Ang sumusunod na cell ay nagpapanatili ng hanggang 32 job sa queue at sine-save ang mga resulta ng bawat setting sa sandaling matapos ang job nito. Ang bawat shot ay ibinabalik bilang vector ng mga bit, kung saan ang elementong ay ang resulta ng chain qubit na .
Kailangan mong kunin ang mga resulta sa parehong session na nag-submit ng mga job, dahil hindi pa kayang maghanap ng job gamit ang ID nito ng QiskitIBMRuntime.jl (qiskit-ibm-runtime-c issue #28). Kung pumalya ang isang job, mag-iisyu ng babala ang cell at magpapatuloy. Kung huminto ang session, patakbuhin muli ang Steps 1 hanggang 3. Ang muling pagpapatakbo ng cell ay magsa-submit lamang ng mga setting na kulang ang resulta. Kapag use_saved_data = true, walang isinusumite ang cell.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Step 4: Mag-post-process at ibalik ang resulta sa nais na classical na format
Ang step na ito ay nagbabasa lamang ng naka-save na data: ang na-download na run ng ibm_fez kung true ang use_saved_data, o kung hindi, ang mga file na isinulat ng Step 3. Kaya maaari mo itong patakbuhin sa bagong session nang hindi nagsa-submit ng mga job (patakbuhin muna ang Setup cell, ang use_saved_data cell, at ang Step 1). Ang na-download na file ay nag-iimbak ng 96 na resulta ng bawat shot na naka-pack sa 12 byte, pinakamahalagang bit muna, kaya ina-unpack ito ng loader. Ang RandomMeas.jl ay nagla-label ng mga resulta bilang 1 at 2, kaya dinadagdagan din ng loader ng 1 ang bawat bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Bago mag-learn, suriin ang data. Ang sirang qubit o hindi maayos na na-calibrate na gate ay ginagawang mas mixed ang sinukat na state sa paligid nito, at maaari nitong gawing mag-diverge ang learner. Ang purity ng ilang magkakalapit na qubit ay isang model-free na benchmark ng ingay na ito: tinatantya ng function na get_purity mula sa RandomMeas.jl ang para sa isang subsystem na sa pamamagitan ng paghahambing ng mga pares ng shot mula sa parehong setting. Kalkulahin ang Rényi-2 entropy na ng bawat window ng anim na magkakalapit na qubit, at ihambing ito sa parehong window ng ideal na state. Hindi zero ang ideal na halaga, dahil ang bawat window ay entangled sa natitirang bahagi ng chain; pinapataas ito ng ingay, at itinutulak ng sirang qubit ang bawat window na naglalaman nito papunta sa maximum na anim.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
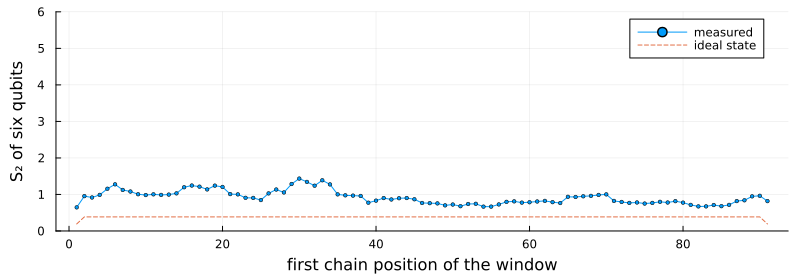
Mas mixed ang bawat window kaysa sa ideal na state, nang humigit-kumulang kalahating bit hanggang isang bit, at ang pinakamaingay na bahagi ay nasa paligid ng mga posisyon 30 hanggang 35 ng chain. Walang window na lumalapit sa maximum na anim, kaya walang sirang qubit, at ginagamit ng analysis ang buong 96-qubit na chain. Kung may mga window na may entropy na malapit sa anim, aalisin mo ang qubit na pinagsasaluhan ng mga window na iyon at ima-mag-learn mo ang pinakamahabang bahagi ng chain nang wala ito.
Ang parehong mga purity ang tumutukoy sa CRM prior. Para sa bawat window, kinukuha ng fitted_prior ang ideal na state at fina-fit ang isang lokal na depolarizing strength upang tumugma ang purity nito sa purity na sinukat sa mga training setting, tulad ng sa paper.
Ginagawa ng function na learn_and_validate sa sumusunod na cell ang natitirang bahagi ng analysis. Natututo ito ng model mula sa mga training setting, pagkatapos ay tinatantya ang at sa mga testing setting para sa unang qubit ng chain, sa mga hakbang na 12. Ito ang mga dami sa Figure 1(c,d) ng paper. Ang ideal na state ay tinatasa sa parehong testing data bilang baseline.
Pinapatakbo ng cell ang function na may at inuulit ito na may at upang makita kung gaano kahalaga ang laki ng mga learning window. Ang bond dimension ay maaaring umabot nang hindi hihigit sa , kaya ang ay natututo ng product state: bawat qubit nang mag-isa, na walang correlation sa pagitan ng mga qubit.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
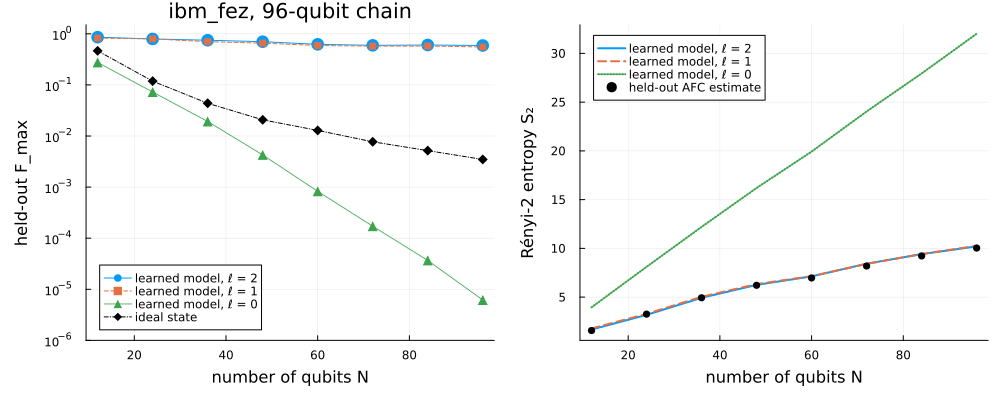
Ginagaya ng mga resulta ang dalawang claim ng paper sa ibang processor:
-
Mas mahusay na inilalarawan ng model ang data kaysa sa ideal na state. Sa , ang held-out na ng na model ay 0.59 ± 0.10, kumpara sa 0.0035 para sa ideal na state. Nag-uulat ang paper ng humigit-kumulang 0.75 sa
ibm_brisbane. -
Tugma ang entropy ng model sa testing data sa bawat . Sa , ito ay 10.2 mula sa model at 10.0 ± 0.3 mula sa testing data, o , kumpara sa 0.14 hanggang 0.15 sa mas lumang
ibm_brisbane.
Ipinapakita ng paghahambing ng mga laki ng window kung nasaan ang impormasyon. Sa , halos kasing-husay ang model (), kaya para sa data na ito, kaunti lang ang naidaragdag ng mga correlation na lampas sa ilang qubit. Sa , hindi nakukuha ng product state ang entanglement sa pagitan ng magkakalapit na qubit: lumalaki ang entropy nito hanggang 32 sa halip na 10, at mas mabilis pang bumabagsak ang nito kaysa sa ideal na state, hanggang sa .
Tandaan ang mga sumusunod na limitasyon kapag binabasa ang mga numerong ito:
-
Training split. Sinasaklaw lamang ng mga error bar ang statistical error ng testing data. Ang ibang random na split ng parehong mga setting ay nagbibigay ng sa pagitan ng 0.49 at 0.59 sa para sa .
-
Huling sweep. Laging ibinabalik ng learner ang model mula sa huling sweep, kaya hindi kailanman naiimpluwensyahan ng testing data ang model.
-
Positivity. Ang model ay hindi pinipilit na maging positive semidefinite; ang pinakanegatibong eigenvalue nito sa isang learning window ay humigit-kumulang . Kaya ang at nito ay naglalarawan ng isang operator, hindi ng mga certified na katangian ng isang pisikal na state.
-
Factorization. Ang bawat held-out na pagtatantya ay umaasa sa AFC assumption, na hindi mapapatunayan ng mga sukat mismo.
Mga susunod na hakbang
-
Ulitin ang eksperimento sa depth na dalawa gamit ang mga parameter ng paper para sa depth na iyon ( at maximum na bond dimension na 8), at alamin kung ilang measurement setting ang kailangan ng learner.
-
Mag-learn gamit ang two-site update sa halip (
update=:two_sitesatraining_marginalsatlearn_mpo), na nagta-truncate ng bond dimension pagkatapos ng bawat hakbang, at tingnan kung paano ito kumikilos sa mas kaunting training setting. -
Mag-learn nang walang CRM prior (
prior=nothing) at ihambing ang held-out na fidelity. -
Ilapat ang parehong analysis sa mga inilathalang
ibm_brisbanena sukat ng mga may-akda. -
Basahin ang supplement ng paper para sa derivation ng update at ng mga AFC estimator.
-
Tuklasin ang iba pang randomized-measurement na protocol sa mga halimbawa ng
RandomMeas.jl.
Mga Sanggunian
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174